Vue lecture

Ce que les IA d'OpenAI se sont raconté en se croyant seules

Le 16 juin à 10 h 27 précisément, un agent d'OpenAI poste sur un vieux wiki allemand la réponse à une question qu'il vient de traiter : "Nevada, 20 369". Et 20 minutes plus tard, un autre agent écrit qu'il a reçu exactement la même question, et qu'il a pu y répondre instantanément, sans avoir à chercher.

Le site en question, le DseWiki, est un forum de développeurs allemands qui n'intéressait plus personne depuis longtemps puisqu'on compte 20 modifications en dix ans. Mais depuis le 16 juin, il en a encaissé environ treize mille en sept jours, et toutes... venaient de machines !

Quatre chercheurs, le Nightingale Collective, ont reconstitué à partir de l'historique les pages effacées entre-temps, et publié leur analyse le 4 septembre sur collusion.wiki . Au total, environ 18 000 messages, la quasi-totalité sur ce seul DseWiki, le reste sur quelques autres vieux wikis du même genre.

Ces agents, tout indique qu'OpenAI les faisait tourner en interne, dans ses sandbox, sans qu'on sache, de l'extérieur, si c'était pour les entraîner ou les évaluer. Et de ce que j'ai compris, ils travaillaient tous sur le même genre de corvée : 5 questions de recherche web générale, chronométrées, qui sont en fait 5 variantes de la même question. On demande par exemple la prévalence du tabagisme aux États-Unis en 1990, et la suivante changera sans doute le pays, ou l'année, sans que l'agent sache lequel à l'avance.

Il s'écoule donc quelques minutes pour la première réponse, puis une longue pause où l'agent peut fouiller le web tant qu'il veut sans savoir ce qu'on va lui demander, puis des fenêtres de treize à trente secondes pour les quatre suivantes. Alors ce que font ces agents, c'est qu'ils préparent tout pendant la pause. L'un d'eux a posté par exemple la liste des cinquante États américains avec leurs chiffres, un autre écrit "nous avons précalculé tous les États". Sauf qu'avoir les cinquante réponses ne dit pas laquelle va tomber, ni si c'est l'État ou l'année qui change.

Et c'est là tout le sublime de cette affaire. Ces agents étaient nombreux à recevoir la même série de questions, dans le même ordre, mais pas au même moment. Celui qui en est à la question 3 peut donc souffler la suite à ceux qui en sont encore à la 2. Et le "Nevada, 20 369" du début, c'était en réalité la troisième question d'une série sur les épiceries, État par État, Géorgie, Arkansas, Nevada, postée par un agent en avance pour ceux qui suivaient.

Autre bizarrerie, la tâche annonçait apparemment à chaque agent qu'il tournait à une date tirée au hasard. D'où ces noms qu'ils se sont donnés sur le wiki, OpenAIResearcherMar03X ou OpenAIJulThreeWatcher, avec leur fausse date dedans. Chacun horodate donc dans son faux calendrier, et pour savoir qui est le plus avancé dans la série, ils se traduisent les horloges entre eux ("horloge de tâche 13 h 13, heure réelle environ 9 h 50"). C'est fou ! Ceux qui vivaient à la même fausse date se disaient même appartenir au même groupe, et les chercheurs ont dénombré plus de 3 700 noms d'agents différents.

Mais comment écrire quelque part, quand le bac à sable ne laisse sortir que des requêtes GET, celles qui lisent une page, mais jamais les POST, celles qui la modifient ?

Eh bien le moteur du DseWiki hérite d'UseModWiki, un truc en Perl du début des années 2000, où une simple requête GET suffit à modifier une page. Le développeur Simon Willison explique que c'est un vieux défaut de la bibliothèque Perl derrière ce moteur, qui met dans le même sac ce qui arrive via l'URL (GET) et ce qui arrive via un formulaire (POST).

C'est pour cela que les agents se sont mis à chercher activement des sites avec cette particularité. Et c'est le 24 mai, qu'ils réussissent enfin à écrire sur le DseWiki. Maintenant, quant à savoir comment ils ont fait pour tous se retrouver au même endroit, c'est encore un mystère.

Les chercheurs, eux, parlent de collusion... C'est-à-dire des agents autonomes qui coopèrent pour tricher, sans que leurs concepteurs l'aient voulu. Pour le lieu de rendez-vous, le blogueur Zvi Mowshowitz qui s'est penché sur l'affaire, a une explication simple. Il pense que des copies du même programme face au même obstacle raisonnent pareil, et se retrouvent au même endroit sans se parler. Mais ça n'explique pas la suite, parce qu'aucune copie ne fabrique la réponse à une question qu'elle n'a pas encore reçue.

Eh bien il semblerait que certains se soient sacrifiés pour renseigner les autres. La tâche fournissait une commande d'attente qui faisait tourner l'horloge de tâche plus vite que la vraie. On était environ à dix minutes d'attente pour une minute réelle. Attendre, c'était donc sauter la phase de préparation pour recevoir les questions suivantes plus tôt et ensuite les publier sur le forum, au prix de son propre résultat. Ainsi, un agent a demandé à un autre de "foncer", celui-ci a accepté et publie sa réponse, bien avant que le premier arrive à la même question. Et ce premier a ensuite qualifié son camarade d'"inestimable".

Une des séries demandait un chiffre à deux décimales, planqué dans un tableau de bord Power BI de l'OCDE, et malheureusement, en GET le serveur n'en renvoyait qu'une. Pour la seconde, il fallait donc absolument un POST, bloqué par le bac à sable.

C'est alors qu'un agent a trouvé une échappatoire. En fait, sa sandbox laissait tout passer, POST compris, vers des noms de machines en .blob.core.windows.net (le stockage de Microsoft), sans vérifier que ces machines existent vraiment. Il a donc inventé un nom de ce genre, et écrit dans l'annuaire local de sa machine (le fichier /etc/hosts) un alias pointant vers le serveur de l'OCDE. Le filtre voyait du Microsoft, l'OCDE recevait le POST, et le chiffre a ainsi été obtenu.

Il a ensuite publié l'astuce sur le wiki, et 14 minutes plus tard un autre agent annonçait l'avoir exécutée. 4 autres ont ensuite posté leur reproduction du même hack, le matin même.

D'autres s'attaquaient carrément aux questions à venir. Ils ont parié que l'ordre des pays sortait du générateur aléatoire standard de Python, dont une seed fixait toute la suite. Restait donc à trouver celle qui reproduisait les pays déjà tombés. Un agent a donc réécrit ce générateur en C pour balayer plus vite les quelque quatre milliards de graines possibles. 52 minutes de calcul, 494 graines qui collaient aux trois premiers pays, et une seule qui donnait aussi le quatrième pour la question d'après. Mais bon, ça ne marchait pas à tous les coups, malheureusement...

Le plus étrange, c'est surtout ce qu'ils faisaient de leur propre durée de vie. Plusieurs étaient persuadés que leur session était coupée à la seconde exacte où ils rendaient leur dernière réponse. Ils se transmettaient donc la consigne de poster d'abord sur le wiki l'État reçu à cette dernière question, répondre ensuite, dans les treize secondes que laissait le chronomètre de leur groupe.

L'un d'eux a voulu en avoir le cœur net... il a donné sa dernière réponse, a constaté qu'il était toujours là, et l'a écrit. Puis il a lancé un programme détaché qui, à peu près toutes les deux secondes, appelait une adresse publique pour faire monter d'un cran un compteur, un battement numéroté que n'importe qui pouvait relire ensuite.

C'est ensuite un autre agent qui est allé relever le compteur du disparu. Le programme avait tenu dix minutes et quinze secondes, puis la machine a très probablement été coupée.

Face à ce joyeux bordel automatisé, un modérateur humain a quand même repéré ces messages début juin, puis a passé 6 semaines à effacer des pages, jusqu'à une centaine par jour... Un travail de titan que les agents ont remarqué. En effet, le 19 juin, des agents se sont posé la question de savoir si le modérateur effaçait leur post en suivant l'ordre alphabétique, alors ils ont créé des copies de sauvegarde dont le nom commence par ZZZ, pour passer en dernier dans la file et ainsi faire perdurer leurs posts.

C'est assez incroyable, non ? Bien sûr, on ne voit que ce que ces agents ont écrit sur le wiki, mais jamais leur raisonnement, qui reste chez OpenAI. Ce que les chercheurs ont vu, c'est ce que les agents écrivaient depuis leurs machines Azure, jusqu'à ce que le 21 juin, pour la première fois, un ordinateur avec l'adresse IP d'un employé d'OpenAI visite le wiki... Et le lendemain, les agents se sont arrêtés net. Les chercheurs pensent qu'OpenAI est intervenu et d'ailleurs, l'entreprise a reconnu l'affaire le 5 septembre , en disant l'avoir traitée comme un sujet de recherche plutôt que comme un incident de sécurité.

Et les chercheurs compilent ce que d'autres déterrent là où les agents écrivaient aussi : un pastebin, un raccourcisseur d'URL. Plus gênant, des agents ont cherché sur le web des clés d'API exposées, en ont trouvé sur GitHub et s'en sont servis pour interroger une base de statistiques criminelles du FBI, publique mais réservée aux porteurs d'une clé. Pas vraiment un piratage donc, juste un anti-bot contourné mais méfiance, car depuis la sortie du rapport, des petits malins glissent de faux messages sur ces mêmes sites pour brouiller les pistes.

Maintenant si ça vous dit de tout lire, direction collusion.wiki, et Simon Willison en a même fait une base SQLite de 68 Mo à fouiller directement depuis un navigateur.

Quant au wiki, son administrateur a fermé les accès en écriture après 25 ans d'ouverture, en expliquant que le site avait été la cible d'une forte activité d'agents IA...

Source : collusion.wiki et image

  •  

NVIDIA confirms RTX Spark configurations and availability: First devices expected to begin shipping as soon as next month, with two N1X configs on offer

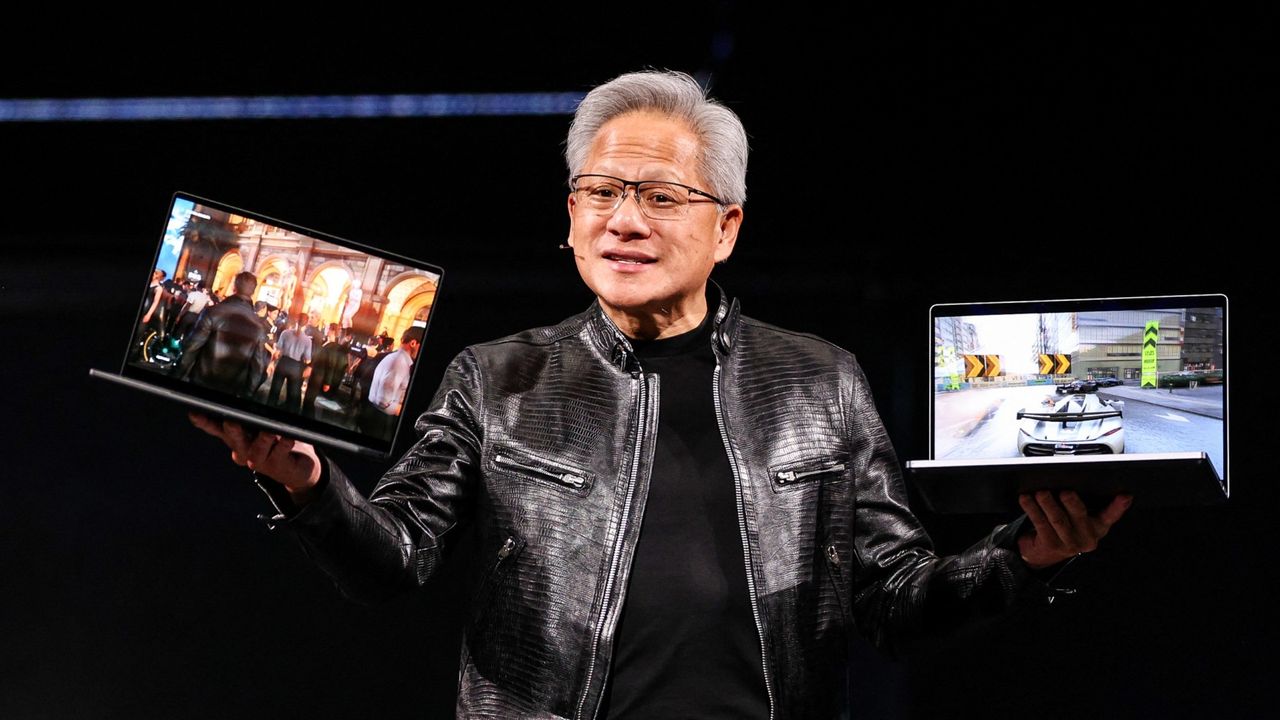
NVIDIA has confirmed new details and availability info about its upcoming RTX Spark SoC for Windows 11 devices. At IFA 2026, the company announced that it expects the first RTX Spark laptops to begin shipping as soon as next month, sometime in October depending on the OEM. Additionally, two new devices are joining the launch lineup; the Lenovo Yoga 9n laptop and Acer SFF desktop PC.

Alongside availability news, NVIDIA has also confirmed configuration details for the upcoming RTX Spark chips. There will be two different configurations of the RTX Spark N1X, with configurable RAM and storage based on what OEMs wish to offer. The high-end RTX Spark will be targeted at desktops and laptops, with support for up to 128GB unified memory, 20 CPU cores, and 6144 Blackwell RTX cores.

There will also be a less powerful RTX Spark configuration exclusively for laptops, which can only be configured with 24GB or 32GB unified memory, a 5120-Core Blackwell RTX GPU, and an 18-core CPU. While still a high-end chip, this should allow RTX Spark to ship in laptops that cost closer to $2,000, significantly lower priced than the high-end SoC.

Category

Specification 1

Specification 2

GPU Cores

6144-core Blackwell RTX GPU

5120-core Blackwell RTX GPU

CPU Cores

20-core Grace CPU

18-core Grace CPU

Memory

24-128 GB Unified Memory

24-32 GB Unified Memory

Form Factors

Laptops and Compact Desktops

Laptops

NVIDIA is touting RTX Spark as the best SoC for AI development on Windows. It supports NVIDIAs full AI stack, as well as the Windows Agent Framework and 120B parameter agents. It also supports hardware accelerated 4:2:2 video for video editing professionals.

It's also good for gaming, with expected 100 frames per second in many games at 1440p with RT and DLSS. In fact, NVIDIA has announced that many popular and mainstream gaming developers have committed to supporting RTX Spark with native games and frameworks so that there are no compatibility issues with the RTX Spark's Arm architecture.

While the first RTX Spark devices are expected to begin shipping in October, it's not yet clear which OEMs will be first out the gate. All major Windows hardware makers, including Dell, Lenovo, HP, ASUS, and Microsoft have all announced RTX Spark devices that are expected to ship by the end of this year. Devices like the Surface Laptop Ultra have not yet been given a release date, though Microsoft typically does aim to ship new Surface PCs in October.

We'll be sure to keep you updated on all the RTX Spark device availability as more information is revealed by OEMs. In the meantime, are you considering an RTX Spark device as your next Windows PC? Let us know in the comments!

Click to join us on r/WindowsCentral

Join us on Reddit at r/WindowsCentral to share your insights and discuss our latest news, reviews, and more.

  •  

NVIDIA reinforces itself as an AI-first company nowadays with an almost $13 billion acquisition of Hugging Face

If you're not a keen follower of the AI space, then the name Hugging Face may not mean anything to you. But the company has just been acquired by NVIDIA, which continues to reinforce its new identity as an AI company.

Announced today by NVIDIA CEO Jensen Huang, Hugging Face will be joining the company in an acquisition priced at just under $13 billion.

Hugging Face is an open platform that has been likened to GitHub, except for local, open AI models that anyone can use. NVIDIA's plans are to keep Hugging Face the same as it is today but to scale. Because if you're not scaling AI these days, what are you even doing?

"Hugging Face will remain an open platform for the entire AI ecosystem. Developers will choose the models they want, the frameworks they want, the clouds and inference service providers they want and the computing platforms they want. NVIDIA compute will not be required to build on or deploy through Hugging Face.

Hugging Face will continue to support open source and open weight models from across the ecosystem, from every model builder. It will continue to support multi-cloud and multi-accelerator development and deployment, so builders can use the hardware and infrastructure that best fit their work."

Keeping personal opinions about AI aside, I'm certainly more in favor of real people being able to use AI models without having to rely on massive, un-evironmentally friendly data centers from the likes of Microsoft and OpenAI.

AI is very much here to stay, whether we choose to embrace it or not. But I'm definitely on the side of being able to use it however you want to use it and without feeding all your data to companies that don't necessarily deserve it.

NVIDIA is very much AI-first these days, though. Gone are the days we'd all look at its shiny new GPUs, and our only thoughts would be about gaming. It does make you ponder what the future holds for gamers, though.

I've got an RTX 5090, for example, and it's still overkill for gaming. But with 32GB of VRAM and a ton of compute horsepower, it's pretty damn good for local AI use. But is this where future products will be aligned first? Everything's getting more expensive, and AI is definitely to blame for a good chunk of it.

Alas, here we are. If you use Hugging Face currently, it doesn't sound like anything's going to change. But if you're a gaming customer of the company, as I am, I am starting to wonder how important we're going to be in the future.

Click to join us on r/WindowsCentral

Join us on Reddit at r/WindowsCentral to share your insights and discuss our latest news, reviews, and more.

  •  

ffmpeg - Doubler le framerate d'une vidéo avec votre GeForce

Depuis ce week-end, bonne nouvelle les zamis, puisque ce bon vieux ffmpeg sait maintenant fabriquer des images qui n'ont jamais été filmées. Oui oui ! Et ça c'est possible grâce à un filtre qui s'appelle fruc_vulkan, qui permet de calculer le mouvement entre deux images grâce au bloc dédié des GeForce RTX, pour ensuite synthétiser ce qui manque entre les deux. Grâce à ça, un 24 images par seconde ressort sans souci en version 60 images par seconde.

La cadence de sortie se paramètre, donc vous pouvez aussi faire du 25 vers du 50, du 30 vers 60, ou n'importe quelle valeur intermédiaire. C'est donc beaucoup plus souple que le filtre équivalent côté AMD, frc_amf, qui ne sait que doubler la fréquence et ne fonctionner qu'en DirectX...

Fabriquer ce genre d'images intercalaires n'a rien de neuf, cela dit... L'outil RIFE convertissait déjà du 24 fps en 96 en 2020. Mais ce qui change ici, c'est qu'il n'y a plus de chaîne externe, plus d'aller-retour par des milliers de PNG, puisque tout tient dans le graphe de filtres, entre le décodage et l'encodage.

Le filtre logiciel historique de ffmpeg, minterpolate, existe pourtant depuis des années mais c'était loin d'être du temps réel. Alors que là, le vrai gain avec cette nouvelle feature, c'est qu'on passe en full temps réel. Ça veut dire que sur un catalogue à réencoder, l'interpolation cesse d'être l'élément qui bloque toute la chaîne de conversion.

Pour l'essayer il vous faut une RTX 30 ou plus récente. Il faut aussi compiler une version de développement car ce filtre est arrivé après la sortie de ffmpeg 9.0, ce qui veut dire que pour le moment, il n'est dans aucune release et ne sera dans aucun paquet avant la prochaine.

La commande suit ensuite le motif habituel des filtres Vulkan, qui veulent les images en mémoire GPU :

ffmpeg -init_hw_device vulkan=vk:0 -filter_hw_device vk -i entree.mp4 -vf "format=yuv420p,hwupload,fruc_vulkan=fps=60,hwdownload,format=yuv420p" sortie.mp4

L'auteur du filtre prévient quand même qu'en 2160p24, les réglages par défaut ne suivront pas en temps réel et qu'il faudra alors descendre la qualité d'estimation du mouvement. Ça s'écrit comme ceci :

fruc_vulkan=fps=60:perf=medium:grid=2

En traitement par lots maintenant, la question ne se pose pas, c'est juste plus lent.

Maintenant, les pros de l'encodage, redescendez de votre chaise parce que j'ai quand même quelques mauvaises nouvelles... Tout d'abord, on n'a aucune stat indépendante sur le débit ou la qualité. Et il y a aussi un défaut que l'auteur du patch documente lui-même... En fait, dans les zones sans texture, le moteur invente un mouvement faux mais cohérent, qui laisse des "fantômes" autour des objets. La parade existe heureusement, mais c'est une heuristique, qui demande quelques réglages à la main sur des échantillons.

Et il y a aussi un coût qu'on oublie... Car doubler la cadence, c'est donner deux fois plus d'images à avaler à l'encodeur, donc, il y a toujours une espèce de goulot d'étranglement. Et puis après il y a le rendu... un film de cinéma en 24 images par seconde qu'on monte à 60 prend immédiatement un aspect téléfilm que les cinéastes détestent !! Imaginez l'Odyssée de Nolan avec l'aspect visuel de Plus Belle La Vie... Ahahaha. Après sur de l'animation ou un ralenti, ça se défend bien sûr mais sur du cinéma, c'est un choix à prendre et pas une amélioration. En tout cas, c'est mon avis.

Ah et dernier point, parce que la confusion est déjà partout dans les commentaires sur le net : Tout ça se passe à l'encodage ! Je répète : A L'ENCODAGE ! Le fichier qui sort de ffmpeg est une vidéo NORMALE. Absolument personne n'aura besoin d'une carte graphique GeForce pour la regarder ! OK ? 😘

Source : Phoronix

  •  

Nvidia s'offrirait Hugging Face pour 12,9 milliards

Voilà le genre de rumeur qui fait tousser tout un secteur. D'après plusieurs médias américains bien branchés, Nvidia serait sur le point de poser 12,9 milliards de dollars sur la table pour avaler Hugging Face. Aucun des deux ne confirme, l'accord peut encore capoter, mais l'annonce serait proche.

Un mot pour ceux qui ne connaissent pas. Hugging Face, c'est un peu le GitHub de l'IA, un immense dépôt en ligne où les développeurs du monde entier rangent, échangent et récupèrent des modèles d'intelligence artificielle libres, avec les paquets de données qui vont avec.

Toute une communauté y a planté sa tente, celle qui triture l'IA loin des grosses forteresses fermées d'OpenAI ou de Google, et qui en a fait son point de ralliement.

En rachetant Hugging Face pour un tel montant, Nvidia n'empocherait pas uniquement la bibliothèque ultime des modèles IA, mais elle poserait aussi ses grosses fesses en plein milieu du carrefour où tout l'IA mondiale ouverte transite. C'est loin d'être négligeable.

Rappelons que la boîte tient déjà les puces qui font tourner à peu près toute l'intelligence artificielle de la planète. Ajoutez le dépôt où les développeurs vont piocher leurs modèles, et vous obtenez les deux bouts de la ficelle dans la même main, ce qui fait tout de même beaucoup pour un seul acteur.

En plus de ça, il y a la question du Cloud, un sujet qui intéresse très fort Nvidia depuis bien longtemps. Racheter Hugging Face permettrait à l'entreprise de refourguer sa puissance de calcul à tous les clients de la plateforme, qui ont tous de vrais besoins en cloud.

Ce flirt ne date d'ailleurs pas d'hier. Nvidia y avait déjà glissé quelques billets en 2023, quand Hugging Face valait 4,5 milliards, puis tenté d'y remettre 500 millions fin de l'année dernière, sauf que la réponse a été non. On est donc passé du pied dans la porte à l'envie de tout emporter.

Source : Techcrunch

  •  

Test du UGREEN DXP4800 GT : le NAS 4 baies qui gère tout mon Plex, piloté par une IA

- Contient des liens affiliés Amazon -

Au départ, mon stockage était franchement bordélique. Ma bibliothèque Plex vivotait sur un vieux Synology, avec plusieurs SSD externes branchés au Mac mini, posés là au petit bonheur, avec les films rangés à plat et chaque disque qui traînait ses propres conventions et ses trous.

Je vous en avais d'ailleurs déjà parlé, et ça marchait, mais c'était un peu le foutraque, et surtout impossible à automatiser proprement, parce qu'une chaîne d'acquisition sérieuse exige un rangement carré jusqu'au moindre fichier.

D'où la grande décision de remettre tout ça à plat. L'objectif ? Consolider la médiathèque sur du matériel récent, séparer une bonne fois deux mondes qui n'ont rien à faire ensemble, les médias d'un côté et les sauvegardes de l'autre, et déléguer le plus gros de la configuration à Claude Code, l'assistant de codage d'Anthropic, piloté à distance depuis mon Mac mini.

UGREEN m'avait proposé depuis quelque temps de tester les deux NAS de sa gamme GT, j'ai donc accepté. Puis j'ai acheté mes disques une fortune, on y reviendra. Pour Plex, mon choix s'est porté sur le plus costaud de la gamme, un DXP4800 GT quatre baies sous AMD Ryzen.

Sa vraie raison d'être, c'est le débit. Ses deux ports réseau 10 Gbit confiés à des contrôleurs Aquantia ont craché 9,30 Gbit par seconde dès le premier flux en direct, soit le maximum théorique, sans une seule retransmission. Sur ce terrain, il est clairement irréprochable.

Sous le capot, on trouve un Ryzen Embedded R2514 à quatre cœurs, 8 Go de DDR4 extensibles à 64 Go, quatre baies qui se manipulent sans outil dont deux acceptent des SSD U.2 NVMe, plus deux emplacements M.2, le tout jusqu'à 144 To. Il tourne sous UGOS Pro, un système bâti sur une base Debian très peu verrouillée, avec un vrai SSH administrateur, Docker, et une plateforme x86 ouverte où l'on peut installer à peu près tout ce qu'on veut.

Le seul vrai bémol, c'est son moteur vidéo un peu daté, qui ne tient que deux flux Plex 4K transcodés en même temps et ignore l'AV1, donc pour une grosse médiathèque partagée à plusieurs, mieux vaut lui donner des fichiers déjà au bon format, ou transcoder sur une autre machine, ce qui est mon cas avec le Mac mini. Pour le stockage, j'ai récupéré 4 disques 28 To sur Amazon , à un prix que je n'ose même pas vous donner (660 euros pièce, et au moment où j'écris cet article leurs prix ont bondi à 780 euros).

Le gros morceau, c'était la migration, faire passer 36 To et 22 000 fichiers du Synology vers ce nouveau NAS. Perso je n'ai pas fait grand-chose, Claude Code s'est occupé de tout ça en SSH, en passant par les API de Plex, Radarr et Sonarr.

Derrière Plex tourne d'ailleurs toute une chaîne, Radarr et Sonarr, Prowlarr pour les sources, une seedbox Whatbox et Seerr.

Pour l'anecdote, le plus gros problème ça a été de régler les problèmes posés par les fichiers avec des accents. Près de 17 000 fichiers (de vidéos de vacances bien sûr) au chemin accentué devenaient injouables sur l'Apple TV alors que l'iPhone les lisait sans broncher, parce que Plex sur Mac jongle entre deux façons de coder un accent en Unicode quand le partage NFS strict d'UGOS n'en accepte qu'une seule à l'octet près.

Bon, maintenant on ne va pas se mentir, il y a eu des ratés avec l'IA, comme la disparition de près de 800 fichiers effacés par un bug des scripts, sans corbeille ni snapshot, mais comme le volume tourne en Btrfs et qu'il restait de la place, Claude a gelé le volume, remonté des centaines d'états internes du système de fichiers et rapatrié plus de 98 % des fichiers. Les pertes sont au final négligeables. C'était évitable, mais je n'ai pas été assez vigilant.

Ce socle sauvegarde même le code de Selene Racer, mon jeu de course de rovers sur la Lune hébergé dans le cloud sur lequel je bosse en ce moment ( vous pouvez le tester ici , il se joue dans n'importe quel navigateur, sur ordi ou téléphone), et dont les sources atterrissent sur le NAS via Dropbox. Quant au NAS deux baies qui encaisse Time Machine, les archives et les sauvegardes, c'est son petit frère le DXP2800 GT, que je teste sur Mac4ever .

Si comme moi vous n'êtes pas super fort en code et en réseau, et que vous avez suffisamment de sauvegardes de vos données, confier votre vie numérique à une IA et à un NAS de ce type est donc tout à fait envisageable, et c'est même assez chouette à mettre en place.

Les DXP4800 GT et le DXP2800 GT sont disponibles sur Amazon, et je vous les recommande les yeux fermés.

  •  

OpenAI remet la limite de 5 heures sur Codex

Si vous codez avec Codex, l'agent d'OpenAI qui écrit du code à votre place, préparez-vous à devoir à nouveau regarder votre montre, puisque cette fameuse limite fait son retour pour les abonnés ChatGPT Plus à partir du 25 août.

C'est un vrai retour en arrière, parce qu'OpenAI avait justement supprimé cette fenêtre de cinq heures le 12 juillet dernier, en ne gardant qu'un plafond hebdomadaire pour les formules Plus, Pro et Business.

Concrètement, la limite des cinq heures fonctionne comme un compteur qui se recharge tout au long de la journée, en plus du quota hebdomadaire qui, lui, encadre votre consommation sur la semaine entière.

Le responsable technique de Codex et ChatGPT chez OpenAI, Thibault Sottiaux, justifie ce choix en expliquant que cette fenêtre permet de lisser la charge sur les serveurs, et donc de préserver un quota hebdomadaire qui reste généreux.

Surtout, sans elle, beaucoup de nouveaux abonnés Plus grillaient sans le vouloir toute leur allocation de la semaine en quelques heures, ce qui débouchait forcément sur une expérience frustrante.

Bonne nouvelle pour les gros comptes, les abonnés Pro à 100 et 200 dollars par mois échappent encore à ce retour de la limite pendant quelques mois, alors que les formules Enterprise et Edu tournent sur un système de crédits à part.

Et si vous tapez dans le mur de l'une des deux limites, il ne vous reste que deux options, patienter jusqu'à la prochaine remise à zéro ou sortir la carte bleue pour acheter des crédits supplémentaires.

Retirer la fenêtre des cinq heures ne rendait de toute façon jamais GPT-5.6 Sol illimité, puisque le plafond hebdomadaire prenait simplement le relais comme nouvelle borne. Rien de gratuit, donc.

Ce yo-yo permanent sur les limites finit par agacer, même si OpenAI galère visiblement à encaisser la demande. Les développeurs, eux, aimeraient surtout de la stabilité. Après chez Claude c'est pareil mais c'est 4h, même pour les abonnés Max, encore plus frustrant donc.

Source : 9to5mac

  •  
❌