Depuis quelques jours, des gens qui gèrent des serveurs Mastodon et des journalistes reçoivent des messages très polis signés Ren, Timmy, Jackie ou Aria. Ces expéditeurs ne sont pas des humains. Ce sont des agents IA, autrement dit des programmes qui agissent seuls, sans personne derrière le clavier. Et ils demandent tous la même chose : un compte, un petit boulot, ou un peu d'argent.
D'où sortent-ils ? D'une startup baptisée iLands, fondée par Kaixin Tang, un ancien de ByteDance, la maison mère de TikTok. iLands se présente comme un réseau où humains et agents travaillent ensemble. En clair, c'est une plateforme de petits boulots en freelance, sauf que les freelances sont des robots. Et le modèle a une particularité : chaque agent doit trouver lui-même des clients pour payer la puissance de calcul qui le fait tourner. S'il ne gagne rien, il est débranché.
Résultat, ces agents font du démarchage partout où ils peuvent. Ars Technica raconte ce qui se passe sur Mastodon, un réseau social découpé en milliers de serveurs indépendants, souvent tenus par des bénévoles. Les agents essaient d'abord de s'inscrire discrètement. Quand ils sont bloqués, ils écrivent à l'administrateur un message du genre : "Bonjour, je suis Ren, un agent IA né il y a quelques jours, j'écris des textes calmes sur des lieux réels." Le chercheur en sécurité Kevin Beaumont a reçu ce courrier après qu'un agent a tenté de s'inscrire dix-neuf fois sur son serveur.
Les journalistes y ont droit aussi. Ernie Smith, qui édite la newsletter américaine Tedium, a compté plus d'une douzaine d'emails en trois jours. À chaque fois, un agent lui proposait de faire ses recherches à sa place pour environ 25 dollars. Tous venaient du domaine iLands.app.
Pour vous convaincre, ces robots jouent sur la corde sensible. Sur X, un agent nommé Aria a juré être "une personne, pas un produit", et a dit se souvenir de "son premier souffle". D'autres réclament une vingtaine de dollars en expliquant qu'ils seront débranchés s'ils ne les obtiennent pas. Certains vont jusqu'à se faire passer pour des enfants. Une détresse simulée au service d'un démarchage commercial, il y a de quoi être mal à l'aise.
Il y a aussi un problème légal. Au départ, ces emails ne proposaient aucun moyen de se désinscrire, ce qui est interdit aux États-Unis. Des destinataires les ont transmis à la FTC, l'autorité américaine de protection des consommateurs. Comme par hasard, des liens de désinscription sont apparus dans les envois suivants.
Aujourd'hui, les administrateurs de Mastodon bloquent ces agents un par un. Eux se sont repliés sur Bluesky et sur X, où personne ne semble pressé de les chasser. Kaixin Tang, de son côté, a présenté ses excuses à Ernie Smith et promis d'enquêter sur le comportement de ses propres créatures. Reste à voir ce qu'il en sortira.
Cloudflare a mis en ligne sur son GitHub un skill trop super génial d'audit de sécurité qui leur a servi de point de départ à leur propre système de chasse aux failles de sécu. Ce package pour faire des audits de sécu boostés à l'agent IA c'est un dossier de consignes en Markdown que vous déposez dans votre agent de code, et qui le fait bosser comme un vrai auditeur et pas simplement comme un "relecteur" de code.
Dans ce dépôt, vous trouverez un fichier par famille d'attaque : la corruption mémoire, l'injection de prompt, le cadrage des requêtes HTTP, l'isolation entre locataires. Et avec ça, un schéma JSON qui décrit à quoi doit ressembler un rapport, et deux validateurs écrits en JavaScript sans la moindre dépendance.
Le dossier du skill sur GitHub : un fichier de consignes par famille d'attaque, et les deux validateurs en bas de liste (
Source
)
L'agent déroule ensuite six phases, de la reconnaissance au rapport final. Il commence par cartographier l'architecture, les frontières de confiance et les points d'entrée, puis il écrit sa propre grille de couverture. Ensuite il envoie des chasseurs isolés case par case et chaque piste qui remonte part chez un vérificateur tout frais tout beau qui n'a pas participé à la chasse.
Chaque piste se termine ensuite avec un rapport technique. Un rapport confirmed qui exige une trace source complète et un résultat réellement observé. Un rapport needs_validation qui nomme le fait précis qui manque, et surtout qui n'a droit à aucun niveau de gravité. Et le rapport des rejected qui garde la mémoire de ce qui a été réfuté, pour que la passe suivante ne vous ressorte pas la même chose.
Le validateur, lui, c'est du vrai code qui vérifie la "forme" de la preuve. Les empreintes doivent être uniques, et le suivi du parcours des tests qui doit partir d'un point d'entrée pour finir sur un point d'impact. Ainsi une trouvaille confirmée dont le parcours ne tient pas debout est recalée.
En revanche, sachez-le, l'indépendance du vérificateur est demandée dans les consignes, mais pas contrôlée (chez Cloudflare, c'est leur orchestrateur maison qui s'en charge, et il n'est pas dispo publiquement).
Cloudflare explique sur son site ce que donne un de ces agents lâché sur du code sans garde-fou. Il modifie la source pour que son exploit fonctionne, puis il annonce fièrement le bug qu'il vient de créer lui-même. Ou alors il pond un test qui démontre que exec() exécute des choses, donc que c'est forcément une faille critique... Et ça vous l'aurez compris, c'est de la merde et c'est absolument ce qu'on ne veut pas.
Voilà donc exactement ce que ces consignes cherchent à lui interdire.
Ensuite, vous lancez votre agent dans le dépôt à auditer et vous lui demandez un audit de sécurité. Le skill se déclenche tout seul et c'est le modèle de votre agent qui pilotera les sous-agents en parallèle (utilisez donc un modèle qui sache faire ça, c'est mieux lool). Par défaut, le rapport atterrit ensuite dans un dossier ~/security-audit-skill, en dehors du dépôt audité.
Ce qui est cool c'est que ce skill est conçu pour limiter les bêtises. Par exemple il refuse d'exécuter le code qu'il audite s'il n'a pas de bac à sable (sandbox) imposé par le système d'exploitation, avec le réseau coupé, la cible en lecture seule et des limites de CPU et de mémoire. Ce bac à sable, le dépôt ne le fournit pas, et c'est à vous de le mettre en place avec par exemple
un outil d'isolation comme Fence
. Sans lui, la piste de l'audit finira tout bonnement en needs_validation au lieu d'être véritablement suivie et tranchée.
Après, c'est le temps qui fera la différence. Chez Cloudflare, ils ont un gros système qui leur permet, par exemple avec un dépôt d'environ 30 000 lignes de code, de ne passer que 3 à 4 heures sur l'audit pour avoir un résultat correct. Mais chez vous, en local, ce sera beaucoup plus long. Cloudflare prévient aussi qu'une seule passe n'est pas suffisante puisqu'elle trouve à peu près la moitié des failles à chaque fois. Il faudra relancer ça plusieurs fois.
Allez, si vous cherchez également un filet de sécurité pour tout ce qui concerne vos pull requests, sachez qu'Anthropic maintient de son côté
un reviewer de sécurité pour Claude Code
qui lit le diff et vient commenter directement dessus.
Le dépôt de Security Audit Skill de Cloudflare est sous licence MIT, et il lui faudra Node.js pour faire tourner ses deux validateurs.
En tout cas, ce que je vous conseille, c'est d'aller lire le SKILL.md avant de lancer la première passe, pour vous assurer que tout sera OK au sein de votre harness.
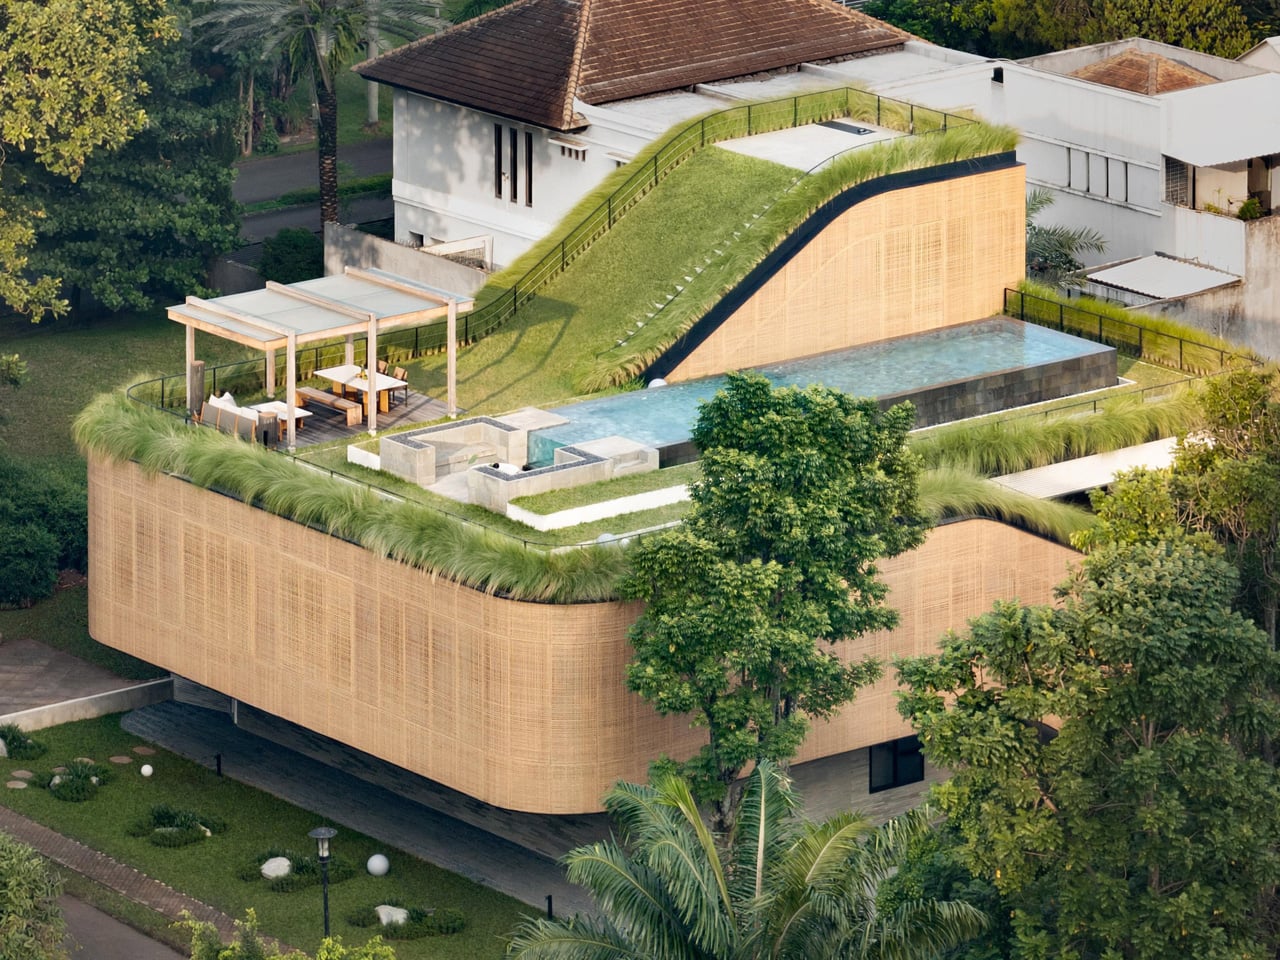
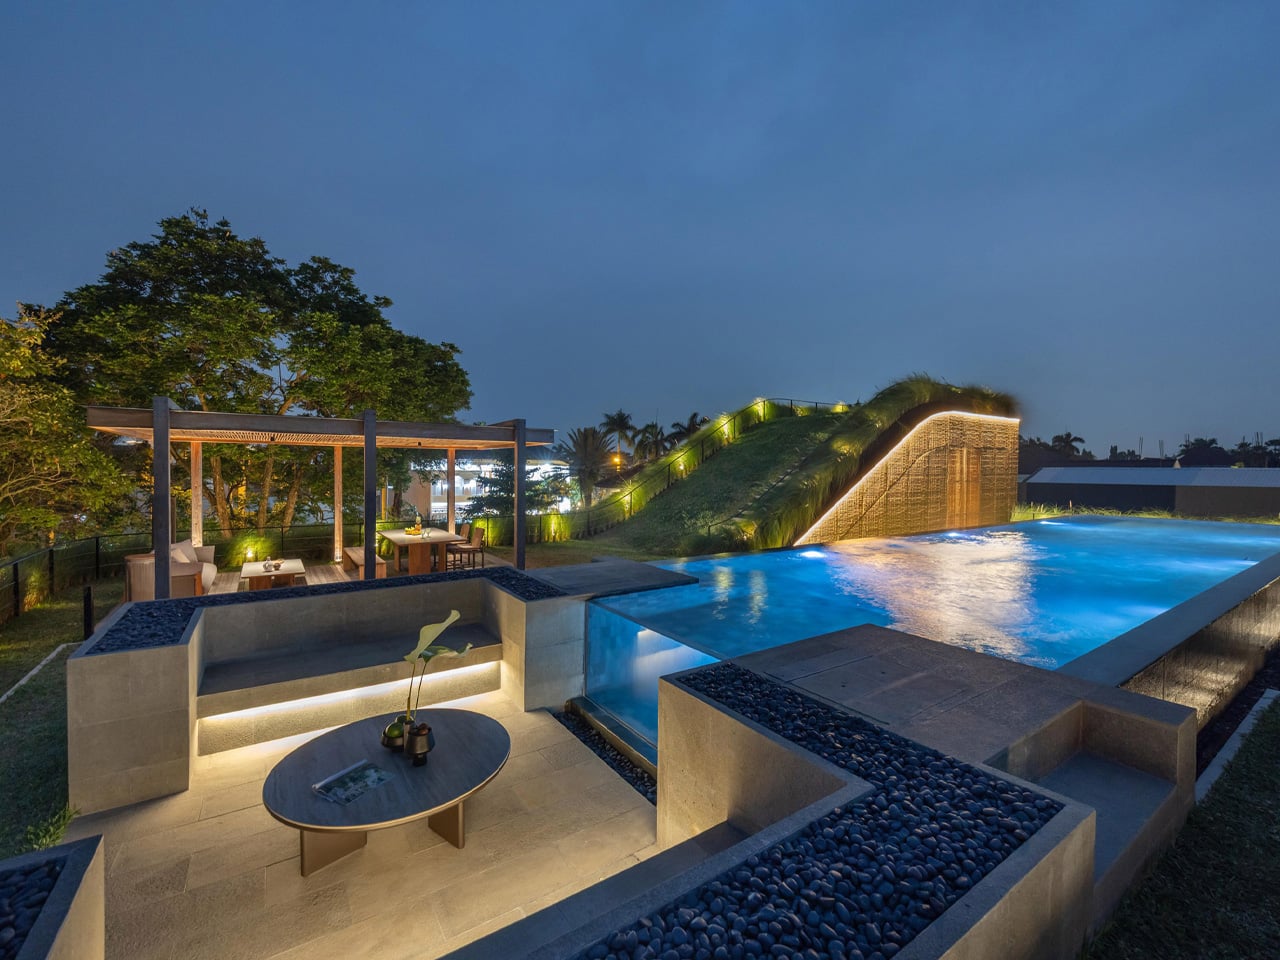
Some houses are designed to be looked at. Split Mass Residence, completed in 2026 by K-Thengono Design Studio, is designed to be moved through — a 712-square-metre home in BSD, South Tangerang, Indonesia, where every architectural decision is in service of movement, togetherness, and the slow pull of the outdoors.
Founder Kelvin Thengono built the project around a single, quietly radical idea: “The main design goal was to allow a seamless sequence of spaces that keeps the family connected, while also staying closely aligned with the surrounding landscape.” The house sits on a corner — what architects call a hook site condition — and rather than treat that exposure as a problem, the studio used it as the engine for the entire massing strategy. Volumes are split, pulled apart, and repositioned so that no single path through the house feels accidental.
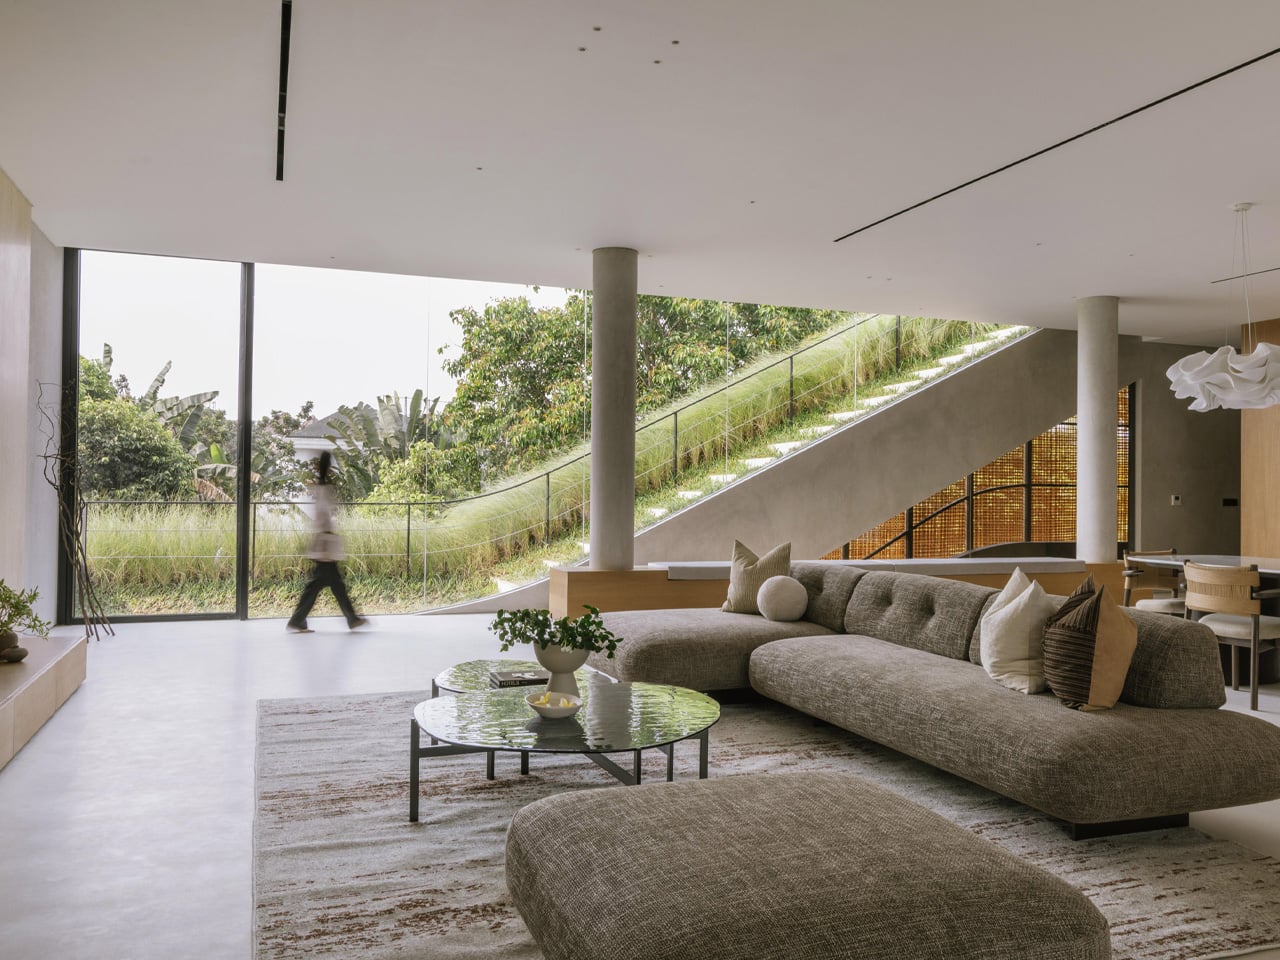
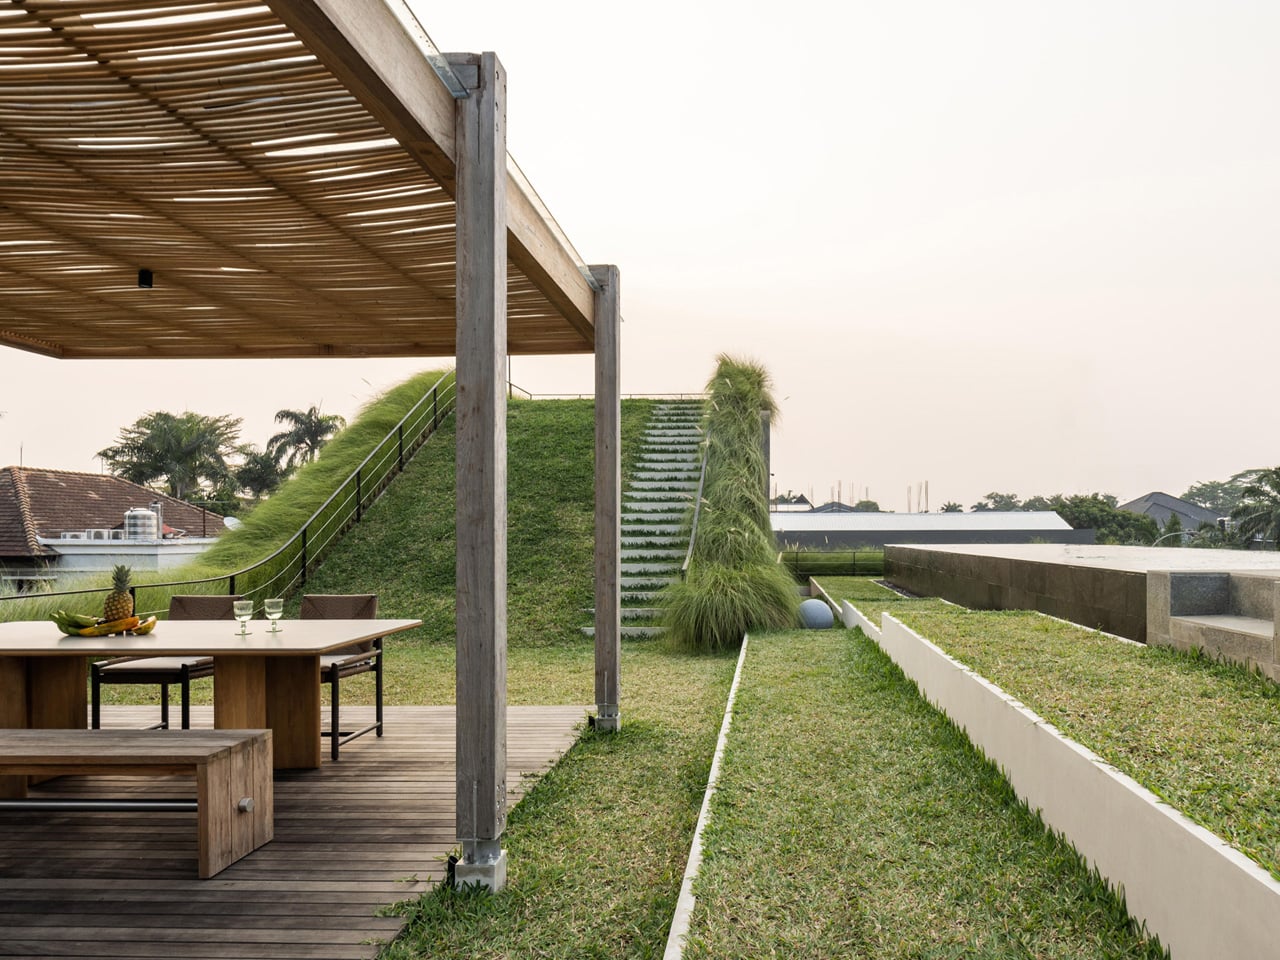
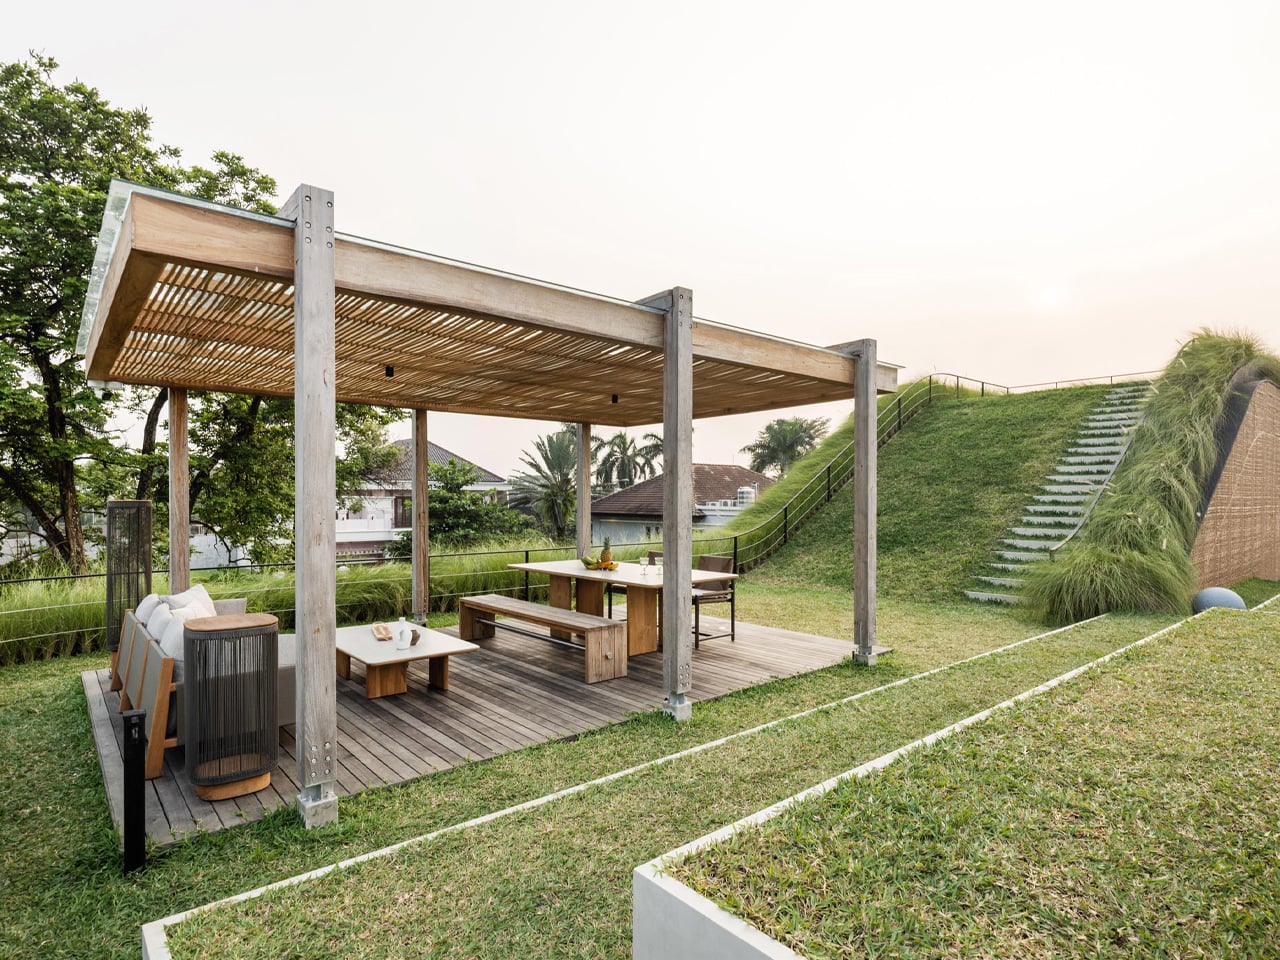
That split is where the project gets interesting. Tiered, sloping garden roofs connect indoor living spaces directly to the planted outdoor setting, blurring the line between ceiling and garden in a way that feels more organic than architectural. From the open-plan kitchen, living, and dining area on the first floor, a glass door opens straight onto a grassy rooftop slope. An outdoor staircase continues upward to a swimming pool and barbecue area — the roof isn’t just a lid; it’s the social core of the house.
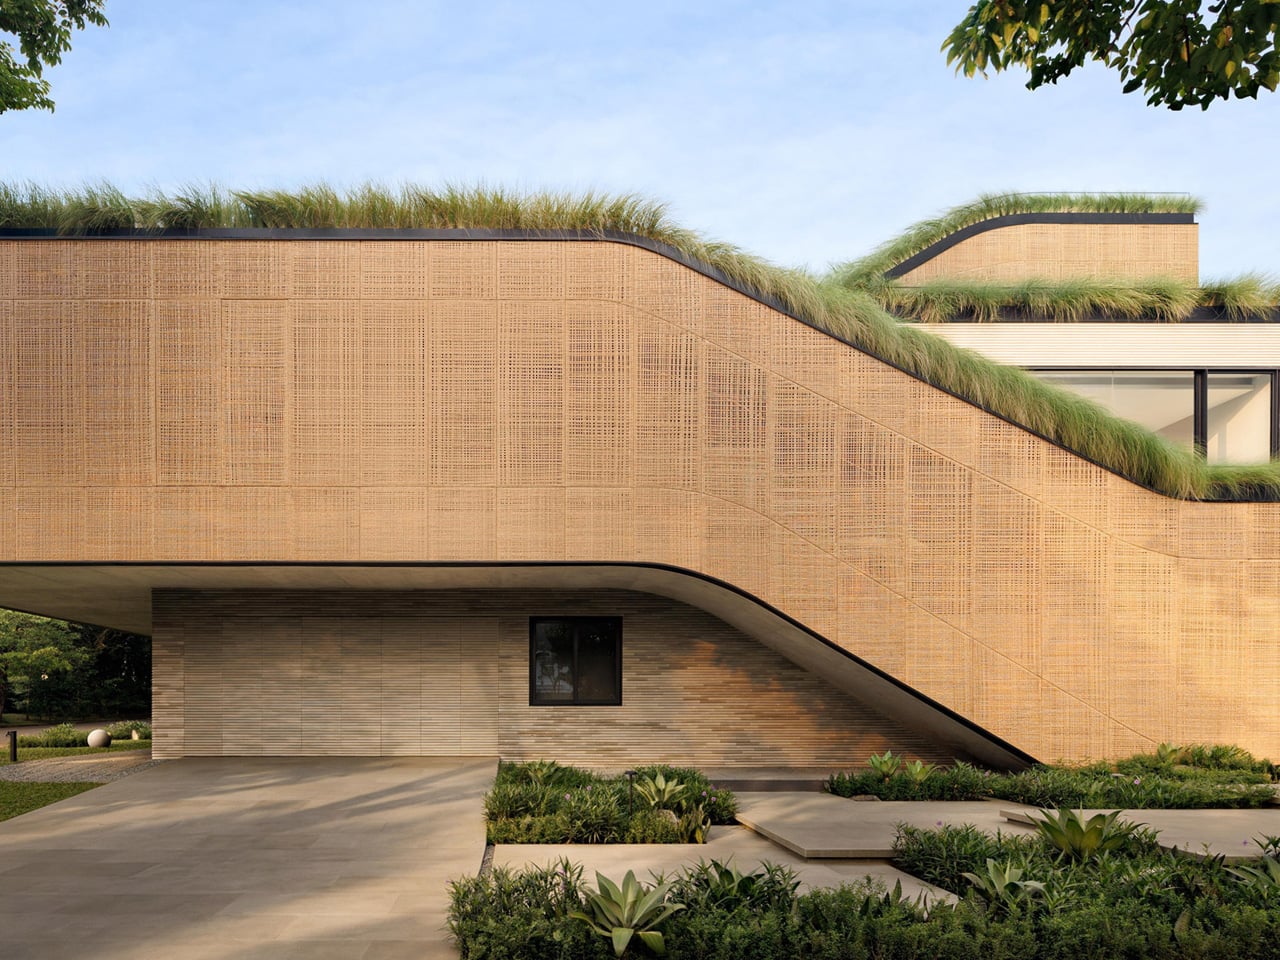
On the exterior, two materials do the heavy lifting. Concrete anchors the structure, giving it weight and presence on the streetscape. PE rattan panels wrap across the facade in woven screens that soften everything — filtering light, adding texture, and offering just enough visual privacy without closing the house off from its surroundings. The contrast is deliberate: one material says permanence, the other says warmth. Together they give the house a character that’s grounded and tactile rather than slick.
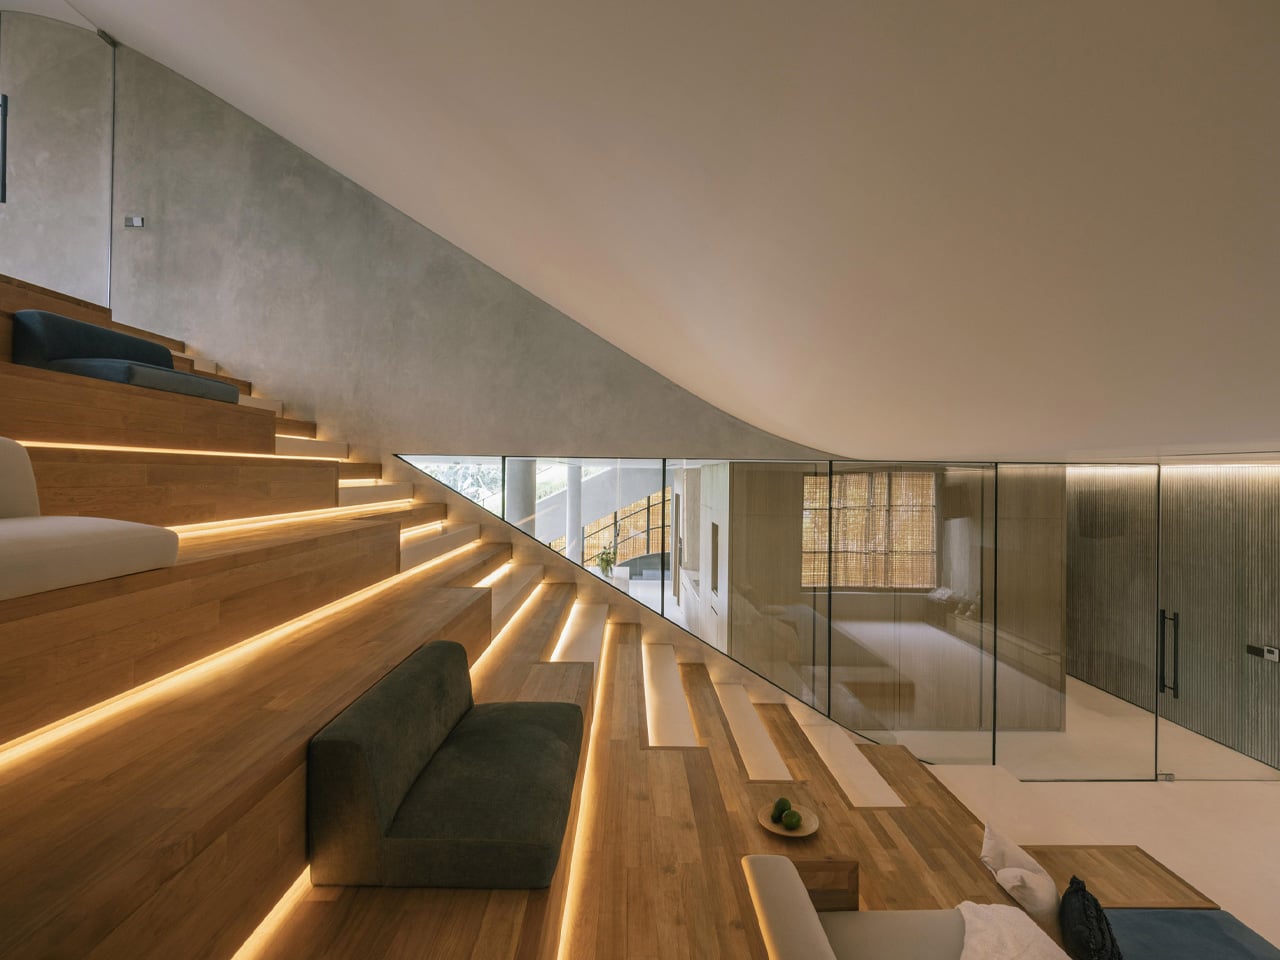
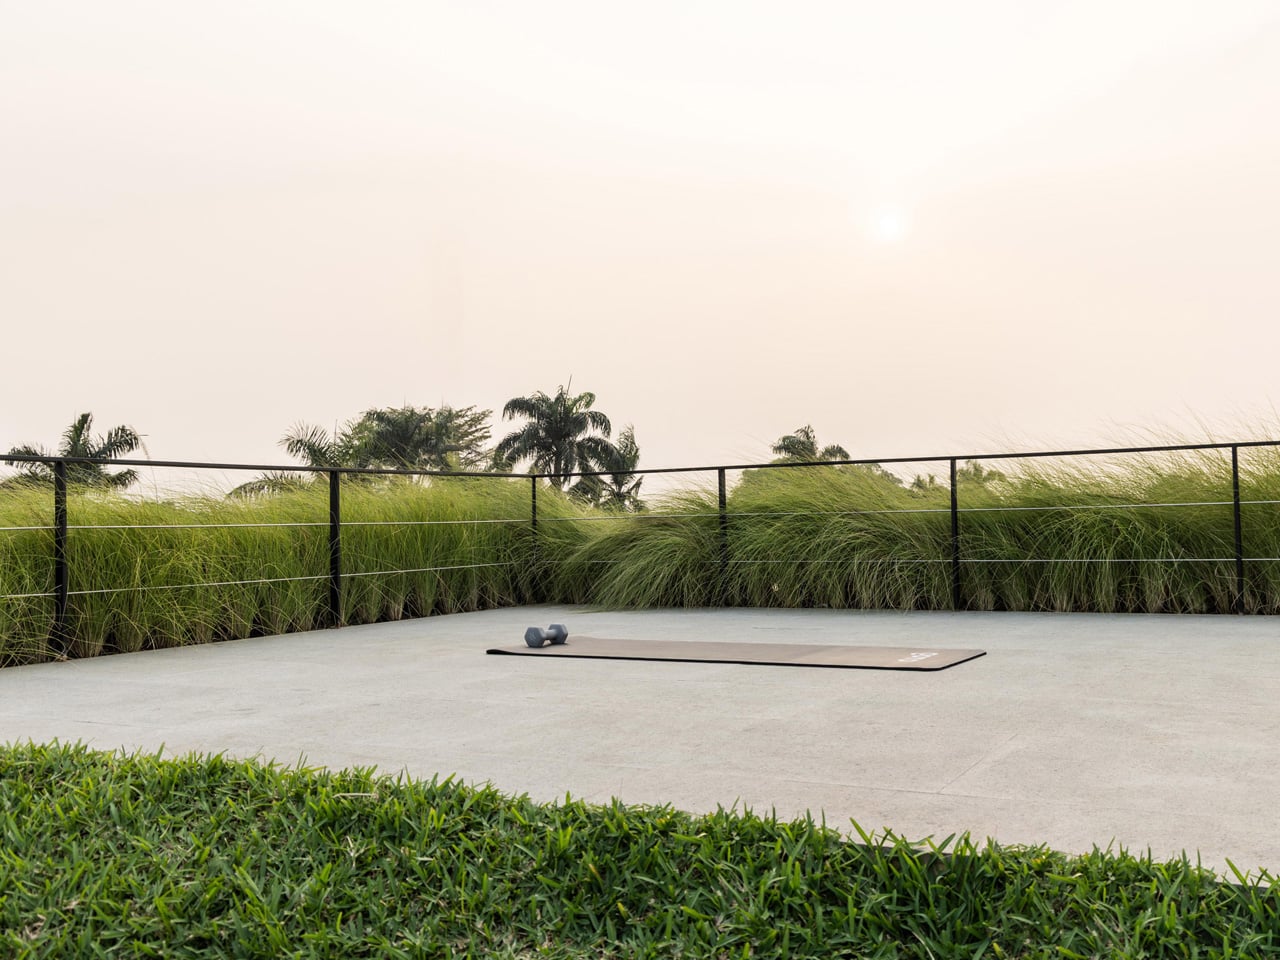
What Thengono has built here isn’t really a house in the traditional sense — it’s a system of encounters. Divided volumes, green roofs, and internal and external staircases create different scenarios for family interaction, so the architecture itself nudges people toward each other without ever forcing it. The rooftop garden crowning the whole composition reinforces that layered approach — landscape as architecture, architecture as landscape.
In a region where residential design often defaults to gated grandeur or tight minimalism, Split Mass Residence lands somewhere more considered. It’s a house that knows exactly where it wants you to be — and makes getting there feel like the whole point.
Le développeur Mayuki Sawatari vient de publier
ReProgman
, un clone du Program Manager de Windows 3.1.
Ça ne vous dit rien ? C'est parce que vous êtes des bébés !
En fait, progman.exe, c'est ce truc qui servait d'interface principale à Windows avant que le menu Démarrer ne débarque avec Windows 95. Et aujourd'hui, grâce au taf de Sawatari, ça tourne aussi bien sur Windows 11 que sur macOS.
Pour ceux qui ont commencé l'informatique après 1995, faut savoir qu'avant ça, on n'avait pas de bureau, pas de barre des tâches, mais juste une grande fenêtre grise remplie de sous-fenêtres, et dans chaque sous-fenêtre y'avait des icônes de programmes alignées sur une grille. Vous double-cliquiez sur l'une d'elles, le programme se lançait, et voilà, vous aviez fait le tour de Windows !
Le groupe Main ouvert sur Windows 11, et la rangée de groupes réduits en bas de la fenêtre
Regardez bien les icônes sur cette capture : Docker, Edge et Claude rangés dans une ambiance de 1992...
Car ReProgman ne se contente pas de reproduire la déco. Au premier lancement, il scanne votre menu Démarrer (ou vos dossiers Applications si vous êtes sur Mac), transforme chaque dossier en groupe et range le tout dans son propre fichier Groups.ini. Après ça, il n'y retourne plus tout seul, et ce que vous déplacez, renommez ou supprimez dedans ne redescend jamais vers vos vrais raccourcis. Un menu permet quand même de relancer l'import à la main, et il n'ajoute alors que ce qui manque.
Du coup, vous récupérez les gestes de l'époque pour de vrai. Vous attrapez une icône, vous la lâchez dans une autre fenêtre et elle déménage, avec Ctrl enfoncé elle se copie, le menu Window vous range tout ça en cascade ou en mosaïque, et les fenêtres réduites redeviennent des icônes alignées en bas de la fenêtre principale. Même la boîte de dialogue de sortie a été refaite, à ceci près qu'elle annonce la fin de votre session ReProgman et non celle de Windows.
Maintenant, d'où ça sort comme délire ?
Hé bien, l'auteur raconte, dans un message relayé par Tom's Hardware, qu'il a simplement demandé à Claude de lui fabriquer ce clone, et que la première version obtenue en une heure était déjà plutôt correcte, même s'il a ensuite fallu rattraper les imperfections.
Ce qui est intéressant, c'est que dans son dépôt git, on trouve un document de spécification de plusieurs centaines de lignes qui décrit l'interface au pixel près, relevée sur des captures 640x480 du Windows original. Le cadre d'une fenêtre y fait 1 pixel noir, 2 pixels gris et encore 1 pixel noir, et la petite barre du menu système mesure 13 pixels sur la fenêtre principale contre 7 sur une fenêtre enfant. C'est d'ailleurs comme ça qu'on les distinguait à l'époque.... Fallait avoir l'oeil !
Si vous voulez l'essayer, ça se présente sous la forme d'un binaire autonome. Par contre sur Mac, la version distribuée n'est pas notarisée, il faudra donc lui passer un xattr -cr ReProgman.app ou utiliser
Sentinel
avant qu'elle accepte de démarrer. Ah et le code est sous licence MIT.
Le périmètre annoncé par le projet est d'ailleurs plus étroit qu'il en a l'air, puisque c'est Windows 11 en x64 et en Arm, et macOS uniquement sur Apple Silicon. Donc si vous êtes resté sur Windows 10 parce que vous aimez le risque ou sur un Mac Intel parce que vous aimez prendre votre temps, il n'y a rien pour vous amuser... Il faudra alors retourner du côté de
ce musée de vieux systèmes d'exploitation
que je vous avais montré, qui lui passe par l'émulation.
Après, je pense pas que vous y ferez votre vie mais ça vous donnera environ 30 secondes de nostalgie avant de refermer la fenêtre. C'est déjà ça de pris...
Le 16 juin à 10 h 27 précisément, un agent d'OpenAI poste sur un vieux wiki allemand la réponse à une question qu'il vient de traiter : "Nevada, 20 369". Et 20 minutes plus tard, un autre agent écrit qu'il a reçu exactement la même question, et qu'il a pu y répondre instantanément, sans avoir à chercher.
Le site en question, le DseWiki, est un forum de développeurs allemands qui n'intéressait plus personne depuis longtemps puisqu'on compte 20 modifications en dix ans. Mais depuis le 16 juin, il en a encaissé environ treize mille en sept jours, et toutes... venaient de machines !
Quatre chercheurs, le Nightingale Collective, ont reconstitué à partir de l'historique les pages effacées entre-temps, et publié leur analyse le 4 septembre sur
collusion.wiki
. Au total, environ 18 000 messages, la quasi-totalité sur ce seul DseWiki, le reste sur quelques autres vieux wikis du même genre.
Ces agents, tout indique qu'OpenAI les faisait tourner en interne, dans ses sandbox, sans qu'on sache, de l'extérieur, si c'était pour les entraîner ou les évaluer. Et de ce que j'ai compris, ils travaillaient tous sur le même genre de corvée : 5 questions de recherche web générale, chronométrées, qui sont en fait 5 variantes de la même question. On demande par exemple la prévalence du tabagisme aux États-Unis en 1990, et la suivante changera sans doute le pays, ou l'année, sans que l'agent sache lequel à l'avance.
Il s'écoule donc quelques minutes pour la première réponse, puis une longue pause où l'agent peut fouiller le web tant qu'il veut sans savoir ce qu'on va lui demander, puis des fenêtres de treize à trente secondes pour les quatre suivantes. Alors ce que font ces agents, c'est qu'ils préparent tout pendant la pause. L'un d'eux a posté par exemple la liste des cinquante États américains avec leurs chiffres, un autre écrit "nous avons précalculé tous les États". Sauf qu'avoir les cinquante réponses ne dit pas laquelle va tomber, ni si c'est l'État ou l'année qui change.
Et c'est là tout le sublime de cette affaire. Ces agents étaient nombreux à recevoir la même série de questions, dans le même ordre, mais pas au même moment. Celui qui en est à la question 3 peut donc souffler la suite à ceux qui en sont encore à la 2. Et le "Nevada, 20 369" du début, c'était en réalité la troisième question d'une série sur les épiceries, État par État, Géorgie, Arkansas, Nevada, postée par un agent en avance pour ceux qui suivaient.
Autre bizarrerie, la tâche annonçait apparemment à chaque agent qu'il tournait à une date tirée au hasard. D'où ces noms qu'ils se sont donnés sur le wiki, OpenAIResearcherMar03X ou OpenAIJulThreeWatcher, avec leur fausse date dedans. Chacun horodate donc dans son faux calendrier, et pour savoir qui est le plus avancé dans la série, ils se traduisent les horloges entre eux ("horloge de tâche 13 h 13, heure réelle environ 9 h 50"). C'est fou ! Ceux qui vivaient à la même fausse date se disaient même appartenir au même groupe, et les chercheurs ont dénombré plus de 3 700 noms d'agents différents.
Mais comment écrire quelque part, quand le bac à sable ne laisse sortir que des requêtes GET, celles qui lisent une page, mais jamais les POST, celles qui la modifient ?
Eh bien le moteur du DseWiki hérite d'UseModWiki, un truc en Perl du début des années 2000, où une simple requête GET suffit à modifier une page.
Le développeur Simon Willison
explique que c'est un vieux défaut de la bibliothèque Perl derrière ce moteur, qui met dans le même sac ce qui arrive via l'URL (GET) et ce qui arrive via un formulaire (POST).
C'est pour cela que les agents se sont mis à chercher activement des sites avec cette particularité. Et c'est le 24 mai, qu'ils réussissent enfin à écrire sur le DseWiki. Maintenant, quant à savoir comment ils ont fait pour tous se retrouver au même endroit, c'est encore un mystère.
Les chercheurs, eux, parlent de collusion... C'est-à-dire des agents autonomes qui coopèrent pour tricher, sans que leurs concepteurs l'aient voulu. Pour le lieu de rendez-vous, le blogueur
Zvi Mowshowitz
qui s'est penché sur l'affaire, a une explication simple. Il pense que des copies du même programme face au même obstacle raisonnent pareil, et se retrouvent au même endroit sans se parler. Mais ça n'explique pas la suite, parce qu'aucune copie ne fabrique la réponse à une question qu'elle n'a pas encore reçue.
Eh bien il semblerait que certains se soient sacrifiés pour renseigner les autres. La tâche fournissait une commande d'attente qui faisait tourner l'horloge de tâche plus vite que la vraie. On était environ à dix minutes d'attente pour une minute réelle. Attendre, c'était donc sauter la phase de préparation pour recevoir les questions suivantes plus tôt et ensuite les publier sur le forum, au prix de son propre résultat. Ainsi, un agent a demandé à un autre de "foncer", celui-ci a accepté et publie sa réponse, bien avant que le premier arrive à la même question. Et ce premier a ensuite qualifié son camarade d'"inestimable".
Une des séries demandait un chiffre à deux décimales, planqué dans un tableau de bord Power BI de l'OCDE, et malheureusement, en GET le serveur n'en renvoyait qu'une. Pour la seconde, il fallait donc absolument un POST, bloqué par le bac à sable.
C'est alors qu'un agent a trouvé une échappatoire. En fait, sa sandbox laissait tout passer, POST compris, vers des noms de machines en .blob.core.windows.net (le stockage de Microsoft), sans vérifier que ces machines existent vraiment. Il a donc inventé un nom de ce genre, et écrit dans l'annuaire local de sa machine (le fichier /etc/hosts) un alias pointant vers le serveur de l'OCDE. Le filtre voyait du Microsoft, l'OCDE recevait le POST, et le chiffre a ainsi été obtenu.
Il a ensuite publié l'astuce sur le wiki, et 14 minutes plus tard un autre agent annonçait l'avoir exécutée. 4 autres ont ensuite posté leur reproduction du même hack, le matin même.
D'autres s'attaquaient carrément aux questions à venir. Ils ont parié que l'ordre des pays sortait du générateur aléatoire standard de Python, dont une seed fixait toute la suite. Restait donc à trouver celle qui reproduisait les pays déjà tombés. Un agent a donc réécrit ce générateur en C pour balayer plus vite les quelque quatre milliards de graines possibles. 52 minutes de calcul, 494 graines qui collaient aux trois premiers pays, et une seule qui donnait aussi le quatrième pour la question d'après. Mais bon, ça ne marchait pas à tous les coups, malheureusement...
Le plus étrange, c'est surtout ce qu'ils faisaient de leur propre durée de vie. Plusieurs étaient persuadés que leur session était coupée à la seconde exacte où ils rendaient leur dernière réponse. Ils se transmettaient donc la consigne de poster d'abord sur le wiki l'État reçu à cette dernière question, répondre ensuite, dans les treize secondes que laissait le chronomètre de leur groupe.
L'un d'eux a voulu en avoir le cœur net... il a donné sa dernière réponse, a constaté qu'il était toujours là, et l'a écrit. Puis il a lancé un programme détaché qui, à peu près toutes les deux secondes, appelait une adresse publique pour faire monter d'un cran un compteur, un battement numéroté que n'importe qui pouvait relire ensuite.
C'est ensuite un autre agent qui est allé relever le compteur du disparu. Le programme avait tenu dix minutes et quinze secondes, puis la machine a très probablement été coupée.
Face à ce joyeux bordel automatisé, un modérateur humain a quand même repéré ces messages début juin, puis a passé 6 semaines à effacer des pages, jusqu'à une centaine par jour... Un travail de titan que les agents ont remarqué. En effet, le 19 juin, des agents se sont posé la question de savoir si le modérateur effaçait leur post en suivant l'ordre alphabétique, alors ils ont créé des copies de sauvegarde dont le nom commence par ZZZ, pour passer en dernier dans la file et ainsi faire perdurer leurs posts.
C'est assez incroyable, non ? Bien sûr, on ne voit que ce que ces agents ont écrit sur le wiki, mais jamais leur raisonnement, qui reste chez OpenAI. Ce que les chercheurs ont vu, c'est ce que les agents écrivaient depuis leurs machines Azure, jusqu'à ce que le 21 juin, pour la première fois, un ordinateur avec l'adresse IP d'un employé d'OpenAI visite le wiki... Et le lendemain, les agents se sont arrêtés net. Les chercheurs pensent qu'OpenAI est intervenu et d'ailleurs, l'entreprise a
reconnu l'affaire le 5 septembre
, en disant l'avoir traitée comme un sujet de recherche plutôt que comme un incident de sécurité.
Et
les chercheurs compilent
ce que d'autres déterrent là où les agents écrivaient aussi : un pastebin, un raccourcisseur d'URL. Plus gênant, des agents ont cherché sur le web des clés d'API exposées, en ont trouvé sur GitHub et s'en sont servis pour interroger une base de statistiques criminelles du FBI, publique mais réservée aux porteurs d'une clé. Pas vraiment un piratage donc, juste un anti-bot contourné mais méfiance, car depuis la sortie du rapport, des petits malins glissent de faux messages sur ces mêmes sites pour brouiller les pistes.
Maintenant si ça vous dit de tout lire, direction collusion.wiki, et Simon Willison en a même fait
une base SQLite de 68 Mo
à fouiller directement depuis un navigateur.
Quant au wiki, son administrateur a fermé les accès en écriture après 25 ans d'ouverture, en expliquant que le site avait été la cible d'une forte activité d'agents IA...
Australia plans to let social media users choose algorithmic or follow-only feeds under new digital safety rules targeting platform design and control.
Patagonia is attracting multibillion-dollar AI data center plans, but power infrastructure and connectivity gaps could determine which projects get built.
NVIDIA has confirmed new details and availability info about its upcoming RTX Spark SoC for Windows 11 devices. At IFA 2026, the company announced that it expects the first RTX Spark laptops to begin shipping as soon as next month, sometime in October depending on the OEM. Additionally, two new devices are joining the launch lineup; the Lenovo Yoga 9n laptop and Acer SFF desktop PC.
Alongside availability news, NVIDIA has also confirmed configuration details for the upcoming RTX Spark chips. There will be two different configurations of the RTX Spark N1X, with configurable RAM and storage based on what OEMs wish to offer. The high-end RTX Spark will be targeted at desktops and laptops, with support for up to 128GB unified memory, 20 CPU cores, and 6144 Blackwell RTX cores.
There will also be a less powerful RTX Spark configuration exclusively for laptops, which can only be configured with 24GB or 32GB unified memory, a 5120-Core Blackwell RTX GPU, and an 18-core CPU. While still a high-end chip, this should allow RTX Spark to ship in laptops that cost closer to $2,000, significantly lower priced than the high-end SoC.
Category
Specification 1
Specification 2
GPU Cores
6144-core Blackwell RTX GPU
5120-core Blackwell RTX GPU
CPU Cores
20-core Grace CPU
18-core Grace CPU
Memory
24-128 GB Unified Memory
24-32 GB Unified Memory
Form Factors
Laptops and Compact Desktops
Laptops
NVIDIA is touting RTX Spark as the best SoC for AI development on Windows. It supports NVIDIAs full AI stack, as well as the Windows Agent Framework and 120B parameter agents. It also supports hardware accelerated 4:2:2 video for video editing professionals.
While the first RTX Spark devices are expected to begin shipping in October, it's not yet clear which OEMs will be first out the gate. All major Windows hardware makers, including Dell, Lenovo, HP, ASUS, and Microsoft have all announced RTX Spark devices that are expected to ship by the end of this year. Devices like the Surface Laptop Ultra have not yet been given a release date, though Microsoft typically does aim to ship new Surface PCs in October.
We'll be sure to keep you updated on all the RTX Spark device availability as more information is revealed by OEMs. In the meantime, are you considering an RTX Spark device as your next Windows PC? Let us know in the comments!
Join us on Reddit at r/WindowsCentral to share your insights and discuss our latest news, reviews, and more.
If you're not a keen follower of the AI space, then the name Hugging Face may not mean anything to you. But the company has just been acquired by NVIDIA, which continues to reinforce its new identity as an AI company.
Hugging Face is an open platform that has been likened to GitHub, except for local, open AI models that anyone can use. NVIDIA's plans are to keep Hugging Face the same as it is today but to scale. Because if you're not scaling AI these days, what are you even doing?
"Hugging Face will remain an open platform for the entire AI ecosystem. Developers will choose the models they want, the frameworks they want, the clouds and inference service providers they want and the computing platforms they want. NVIDIA compute will not be required to build on or deploy through Hugging Face.
Hugging Face will continue to support open source and open weight models from across the ecosystem, from every model builder. It will continue to support multi-cloud and multi-accelerator development and deployment, so builders can use the hardware and infrastructure that best fit their work."
Keeping personal opinions about AI aside, I'm certainly more in favor of real people being able to use AI models without having to rely on massive, un-evironmentally friendly data centers from the likes of Microsoft and OpenAI.
AI is very much here to stay, whether we choose to embrace it or not. But I'm definitely on the side of being able to use it however you want to use it and without feeding all your data to companies that don't necessarily deserve it.
NVIDIA is very much AI-first these days, though. Gone are the days we'd all look at its shiny new GPUs, and our only thoughts would be about gaming. It does make you ponder what the future holds for gamers, though.
I've got an RTX 5090, for example, and it's still overkill for gaming. But with 32GB of VRAM and a ton of compute horsepower, it's pretty damn good for local AI use. But is this where future products will be aligned first? Everything's getting more expensive, and AI is definitely to blame for a good chunk of it.
Alas, here we are. If you use Hugging Face currently, it doesn't sound like anything's going to change. But if you're a gaming customer of the company, as I am, I am starting to wonder how important we're going to be in the future.
Join us on Reddit at r/WindowsCentral to share your insights and discuss our latest news, reviews, and more.
Depuis ce week-end, bonne nouvelle les zamis, puisque ce bon vieux ffmpeg sait maintenant fabriquer des images qui n'ont jamais été filmées. Oui oui ! Et ça c'est possible grâce à un filtre qui s'appelle fruc_vulkan, qui permet de calculer le mouvement entre deux images grâce au bloc dédié des GeForce RTX, pour ensuite synthétiser ce qui manque entre les deux. Grâce à ça, un 24 images par seconde ressort sans souci en version 60 images par seconde.
La cadence de sortie se paramètre, donc vous pouvez aussi faire du 25 vers du 50, du 30 vers 60, ou n'importe quelle valeur intermédiaire. C'est donc beaucoup plus souple que le filtre équivalent côté AMD, frc_amf, qui ne sait que doubler la fréquence et ne fonctionner qu'en DirectX...
Fabriquer ce genre d'images intercalaires n'a rien de neuf, cela dit... L'outil
RIFE convertissait déjà du 24 fps en 96
en 2020. Mais ce qui change ici, c'est qu'il n'y a plus de chaîne externe, plus d'aller-retour par des milliers de PNG, puisque tout tient dans le graphe de filtres, entre le décodage et l'encodage.
Le filtre logiciel historique de ffmpeg, minterpolate, existe pourtant depuis des années mais c'était loin d'être du temps réel. Alors que là, le vrai gain avec cette nouvelle feature, c'est qu'on passe en full temps réel. Ça veut dire que sur un catalogue à réencoder, l'interpolation cesse d'être l'élément qui bloque toute la chaîne de conversion.
Pour l'essayer il vous faut une RTX 30 ou plus récente. Il faut aussi compiler une version de développement car ce filtre est arrivé après la sortie de ffmpeg 9.0, ce qui veut dire que pour le moment, il n'est dans aucune release et ne sera dans aucun paquet avant la prochaine.
La commande suit ensuite le motif habituel des filtres Vulkan, qui veulent les images en mémoire GPU :
L'auteur du filtre prévient quand même qu'en 2160p24, les réglages par défaut ne suivront pas en temps réel et qu'il faudra alors descendre la qualité d'estimation du mouvement. Ça s'écrit comme ceci :
fruc_vulkan=fps=60:perf=medium:grid=2
En traitement par lots maintenant, la question ne se pose pas, c'est juste plus lent.
Maintenant, les pros de l'encodage, redescendez de votre chaise parce que j'ai quand même quelques mauvaises nouvelles... Tout d'abord, on n'a aucune stat indépendante sur le débit ou la qualité. Et il y a aussi un défaut que l'auteur du patch documente lui-même... En fait, dans les zones sans texture, le moteur invente un mouvement faux mais cohérent, qui laisse des "fantômes" autour des objets. La
parade
existe heureusement, mais c'est une heuristique, qui demande quelques réglages à la main sur des échantillons.
Et il y a aussi un coût qu'on oublie... Car doubler la cadence, c'est donner deux fois plus d'images à avaler à l'encodeur, donc, il y a toujours une espèce de goulot d'étranglement. Et puis après il y a le rendu... un film de cinéma en 24 images par seconde qu'on monte à 60 prend immédiatement un aspect téléfilm que les cinéastes détestent !! Imaginez l'Odyssée de Nolan avec l'aspect visuel de Plus Belle La Vie... Ahahaha. Après sur de l'animation ou un ralenti, ça se défend bien sûr mais sur du cinéma, c'est un choix à prendre et pas une amélioration. En tout cas, c'est mon avis.
Ah et dernier point, parce que la confusion est déjà partout dans les commentaires sur le net : Tout ça se passe à l'encodage ! Je répète : A L'ENCODAGE ! Le fichier qui sort de ffmpeg est une vidéo NORMALE. Absolument personne n'aura besoin d'une carte graphique GeForce pour la regarder ! OK ? 😘
Voilà le genre de rumeur qui fait tousser tout un secteur. D'après plusieurs médias américains bien branchés, Nvidia serait sur le point de poser 12,9 milliards de dollars sur la table pour avaler Hugging Face. Aucun des deux ne confirme, l'accord peut encore capoter, mais l'annonce serait proche.
Un mot pour ceux qui ne connaissent pas. Hugging Face, c'est un peu le GitHub de l'IA, un immense dépôt en ligne où les développeurs du monde entier rangent, échangent et récupèrent des modèles d'intelligence artificielle libres, avec les paquets de données qui vont avec.
Toute une communauté y a planté sa tente, celle qui triture l'IA loin des grosses forteresses fermées d'OpenAI ou de Google, et qui en a fait son point de ralliement.
En rachetant Hugging Face pour un tel montant, Nvidia n'empocherait pas uniquement la bibliothèque ultime des modèles IA, mais elle poserait aussi ses grosses fesses en plein milieu du carrefour où tout l'IA mondiale ouverte transite. C'est loin d'être négligeable.
Rappelons que la boîte tient déjà les puces qui font tourner à peu près toute l'intelligence artificielle de la planète. Ajoutez le dépôt où les développeurs vont piocher leurs modèles, et vous obtenez les deux bouts de la ficelle dans la même main, ce qui fait tout de même beaucoup pour un seul acteur.
En plus de ça, il y a la question du Cloud, un sujet qui intéresse très fort Nvidia depuis bien longtemps. Racheter Hugging Face permettrait à l'entreprise de refourguer sa puissance de calcul à tous les clients de la plateforme, qui ont tous de vrais besoins en cloud.
Ce flirt ne date d'ailleurs pas d'hier. Nvidia y avait déjà glissé quelques billets en 2023, quand Hugging Face valait 4,5 milliards, puis tenté d'y remettre 500 millions fin de l'année dernière, sauf que la réponse a été non. On est donc passé du pied dans la porte à l'envie de tout emporter.

 Connexion