❌

Vue lecture

Bitdeer Secures 67 MW for Nvidia AI in Malaysia, but No Customer Deal Announced

Bitdeer is expanding its AI infrastructure footprint in Malaysia with a new 67 MW facility designed for NVIDIA Blackwell systems. Here's what's confirmed about its rollout and customer commitments.

The post Bitdeer Secures 67 MW for Nvidia AI in Malaysia, but No Customer Deal Announced appeared first on TechRepublic.

  •  

Test du Dangbei N3 Max, le projecteur au rapport qualité-prix imbattable

- Contient des liens affiliés Amazon -

Dangbei nous a envoyé il y a quelques semaines son N3 Max , un vidéoprojecteur LED Full HD affiché 499 euros au catalogue mais qu'on trouve à 399 euros sur Amazon en ce moment , et qui mise sur deux arguments assez rares à ce tarif, un pied rotatif intégré et un vrai Netflix certifié. On l'a promené quelques jours entre le salon, la chambre et la terrasse.

Le boîtier de 3,6 kilos est monté d'origine sur un support qui pivote de -45 à +135 degrés, ce qui veut dire qu'on passe du mur au plafond d'un simple geste, sans trépied ni perceuse. Pour regarder un film allongé, c'est carrément agréable.

À chaque déplacement, la machine refait seule sa mise au point, corrige le trapèze, recadre l'image dans la zone libre et contourne même l'étagère qui dépasse. On pose, on attend, on regarde. Et ça fonctionne plutôt bien, même si on a eu quelques fois besoin d'ajuster un peu la mise au point avec la télécommande.

Côté image, on a du LCD Full HD en 1080p qui décode la 4K, une source LED donnée pour 1000 lumens ISO et une diagonale qui monte jusqu'à 150 pouces, même si la marque recommande elle-même de rester entre 80 et 120 pouces pour garder de la luminosité.

Dans une pièce sombre, justement, le résultat est très net, les couleurs sont agréables et on oublie vite le prix de la machine. Volets ouverts en pleine journée, l'image devient moins contrastée, les 1000 lumens ont leurs limites. Le HDR10 est bien là, mais il n'apporte pas grand-chose avec un contraste pareil. Quoi qu'il en soit, à ce niveau de prix, c'est très bon.

Le vrai truc qui fait la différence à ce prix, c'est le logiciel. Le N3 Max tourne sous VIDAA OS, le système d'exploitation des téléviseurs Hisense, avec Netflix, YouTube, Prime Video et Disney+ en versions officielles, sans la moindre clé HDMI à rajouter derrière. AirPlay est aussi de la partie pour envoyer l'écran de son iPhone. Plex fonctionne aussi parfaitement dessus, pour ceux qui ne jurent que par ça.

La télécommande embarque l'assistant vocal VIDAA Voice, qui lance une appli ou une recherche à la voix, sauf sur Netflix qui ne répond pas aux commandes vocales. Les enfants ont droit de leur côté à Kidoodle TV, avec des milliers de programmes gratuits avec contrôle du temps d'écran et heure du coucher paramétrable.

Sous le capot, une puce MediaTek MT9660 épaulée par 1 Go de mémoire et 8 Go de stockage fait tourner l'interface sans ralentissement, et la connectique aligne un port HDMI 2.0 compatible eARC pour renvoyer le son vers un ampli, deux prises USB, une sortie casque en jack 3,5 mm, du Wi-Fi 5 et du Bluetooth 5.0.

Les deux haut-parleurs de 6 watts compatibles Dolby Audio dépannent très bien pour un dessin animé ou un match de rugby (oui je regarde pas le foot, déso), avec des basses quand même un peu timides. Pour une vraie soirée cinéma, on branche une enceinte Bluetooth et tout va mieux.

Un mode jeu à faible latence permet de brancher une console en 1080p à 60 Hz, de quoi jouer tranquillement.

La télécommande n'est pas rétroéclairée, ce qui est agaçant dans une pièce plongée dans le noir, et c'est un problème récurent avec ce genre de produit hélas. Dommage.

Du coup, pour une chambre, un studio ou une toile tendue dans le jardin, le N3 Max fait très bien le job. Les cinéphiles suréquipés n'y trouveront rien, les autres peuvent y aller les yeux fermés, c'est un super rapport qualité-prix. Disponible par ici sur Amazon .

  •  

A Bamboo Music Center Spans Up to 49 Feet Without Columns

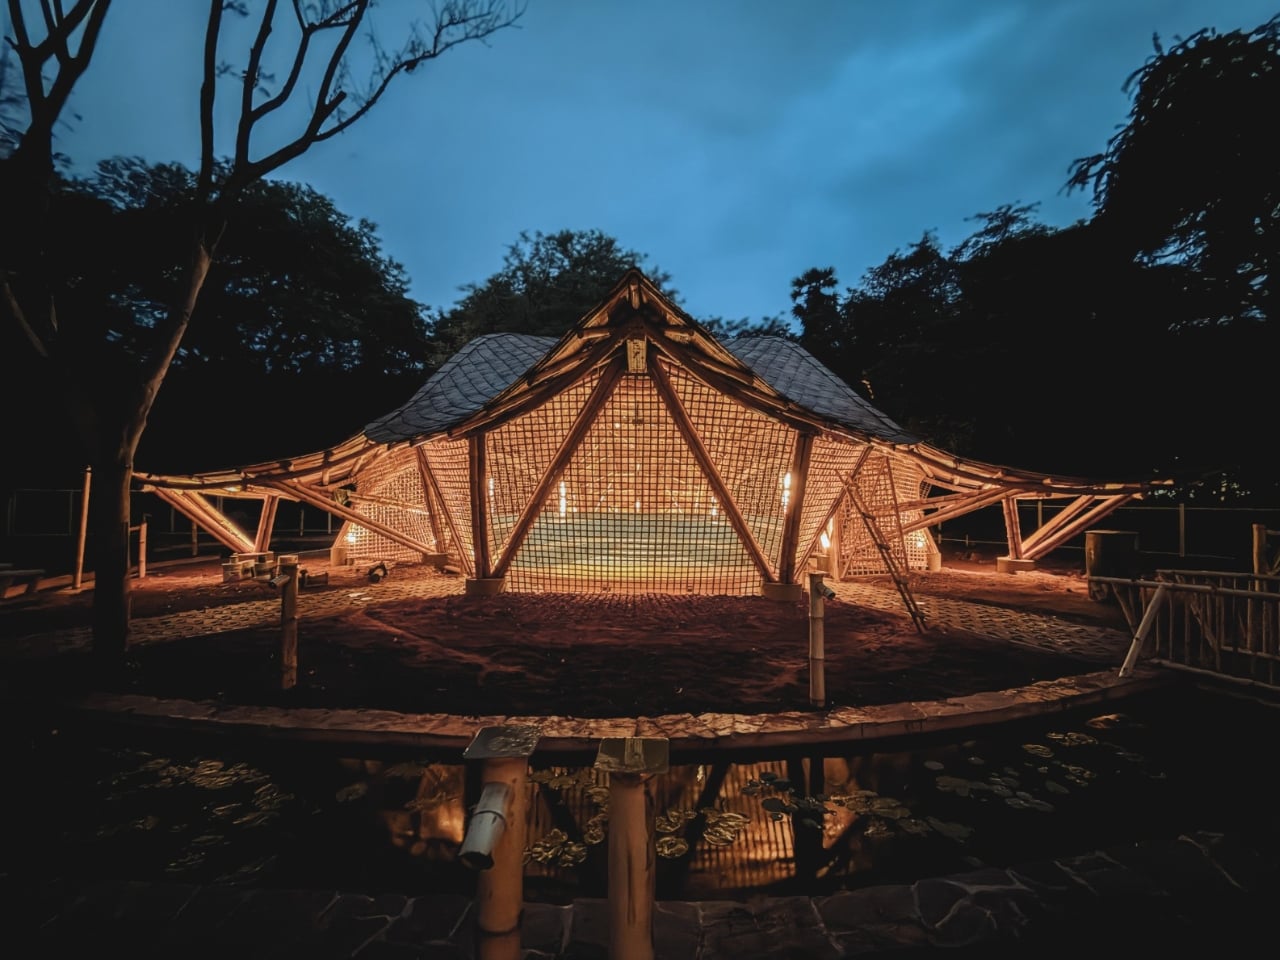
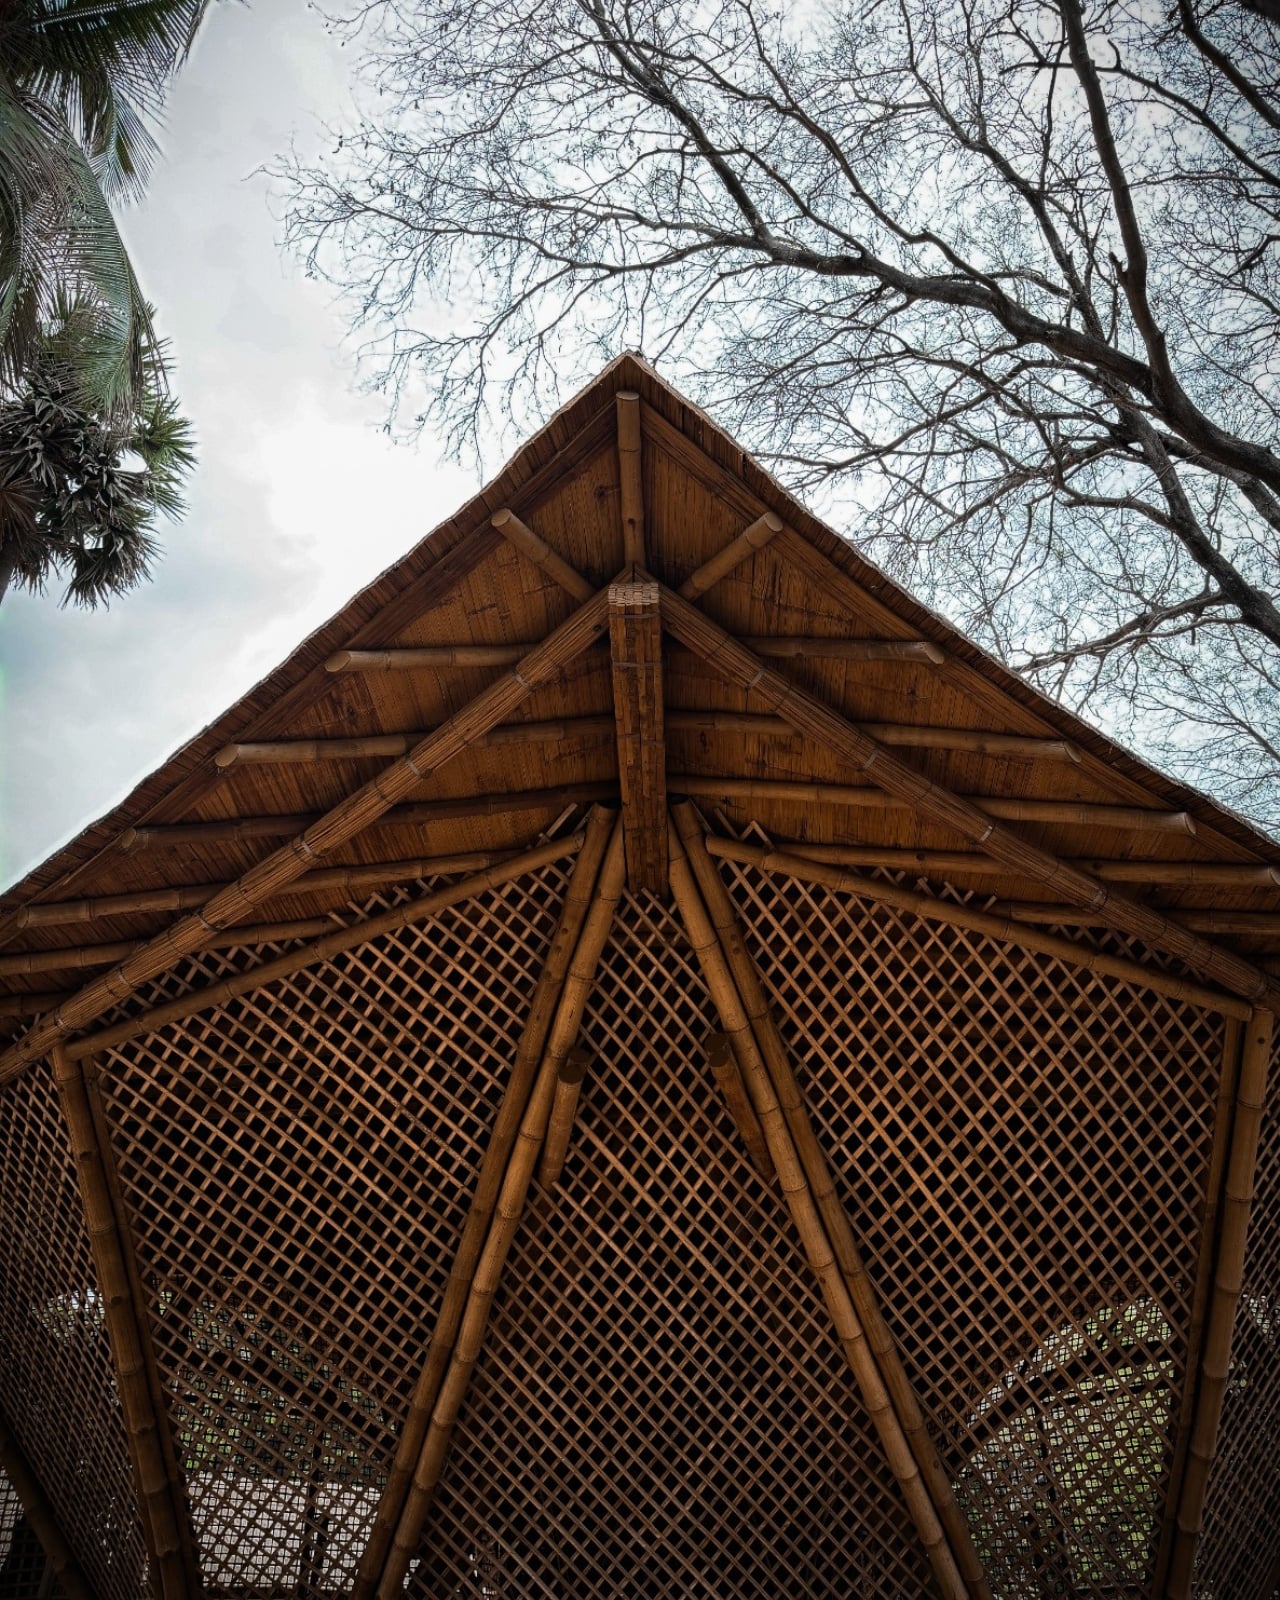
A column in the middle of a music hall means someone has to look around it. That’s a practical problem to solve before worrying about how dramatic the ceiling looks. At the Maestro Ilaiyaraaja Centre for Music Learning and Research in Chennai, India, Ekarth Studio uses bamboo vaults to create spans of up to 49 feet without interior columns. The structure makes room for people to gather, while giving them a roof worth looking up at.

The completed, 10,000-square-foot center at IIT Madras addresses another challenge: bringing music education, research, rehearsal, and recording into one setting. Named for composer Ilaiyaraaja, it belongs to the university’s “Music for All” initiative, whose research interests include acoustics, artificial intelligence, sound synthesis, and instrument design. That’s an unusually broad assignment for a music building. It needs places for focused work, but also room for different disciplines to meet without every encounter becoming a scheduled appointment.

Designer: Ekarth Studio

The roofs give those activities a recognizable home. Ekarth Studio drew their geometry from Bel Patra, the three-part leaf associated with Lord Shiva. Interconnected vaults translate that reference into canopies that rise, dip, and extend over the spaces below. I like that the inspiration has a specific cultural origin. A music center with a curving roof could easily attract a vague explanation about sound waves, but this one has a more deliberate starting point.

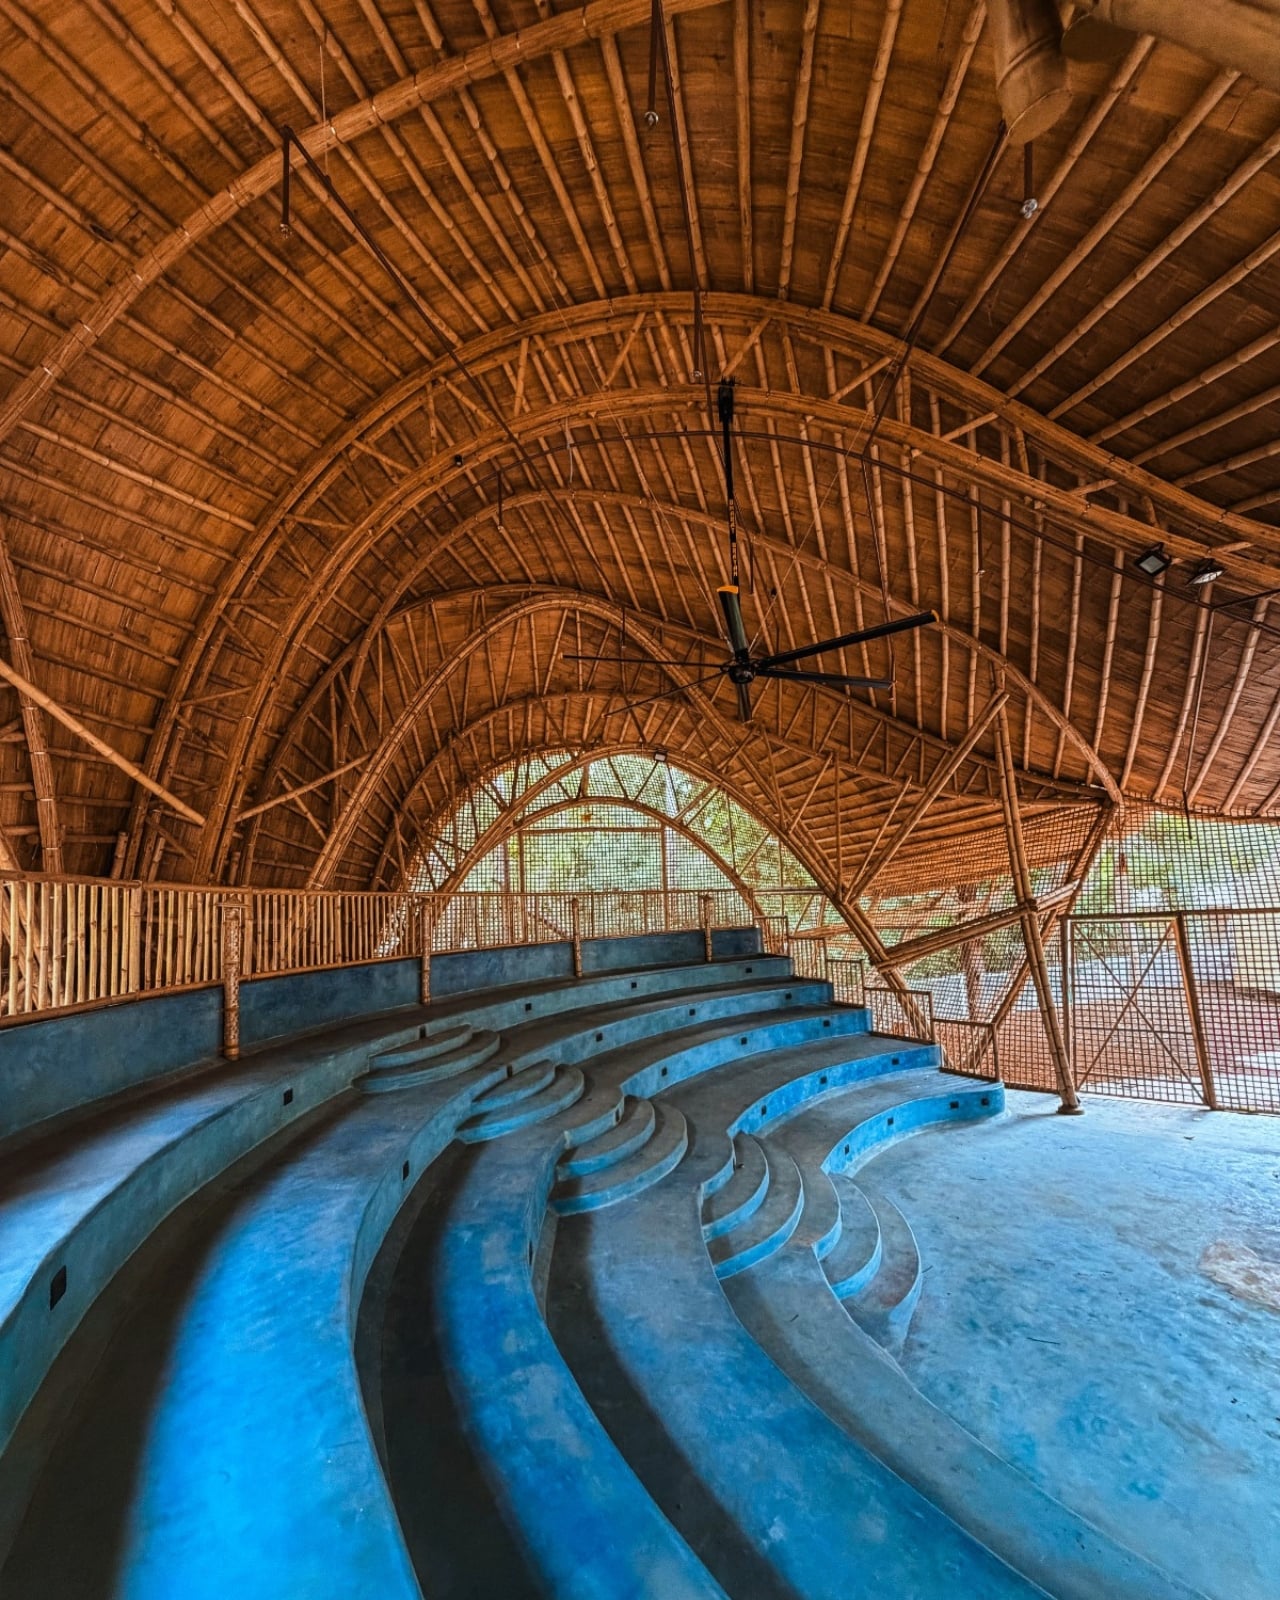
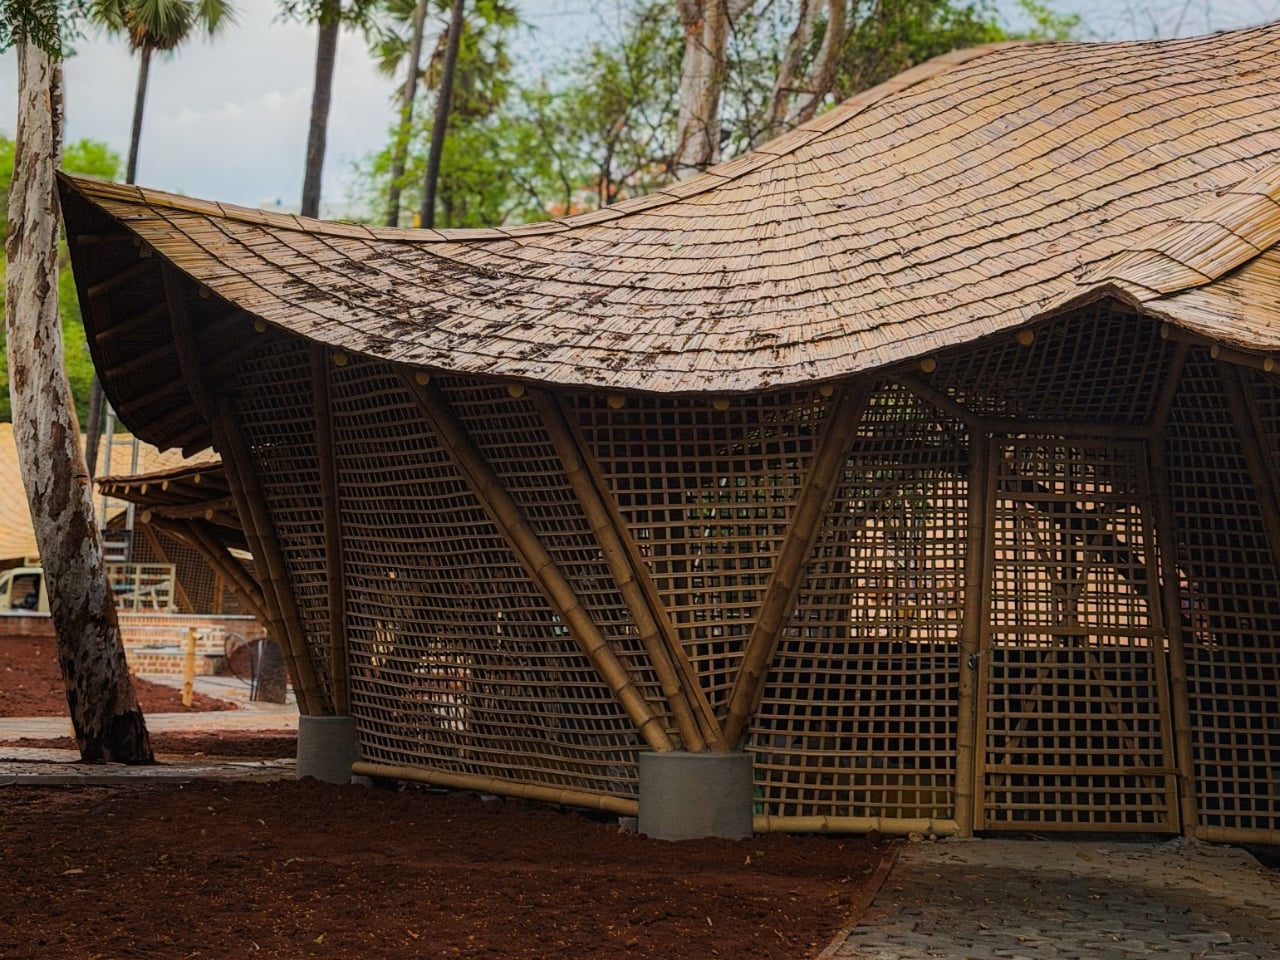
Those curves also involve some serious assembly. The studio describes a structural system combining round bamboo culms, bundled splits, and bundled sticks. Flat bamboo splits are gathered together to form the primary spine beams, rather than relying on a single solid member. Arches reach nearly 30 feet high. The useful distinction is that bamboo carries the roof and establishes its shape. Calling it a decorative finish would miss the most interesting decision in the project.

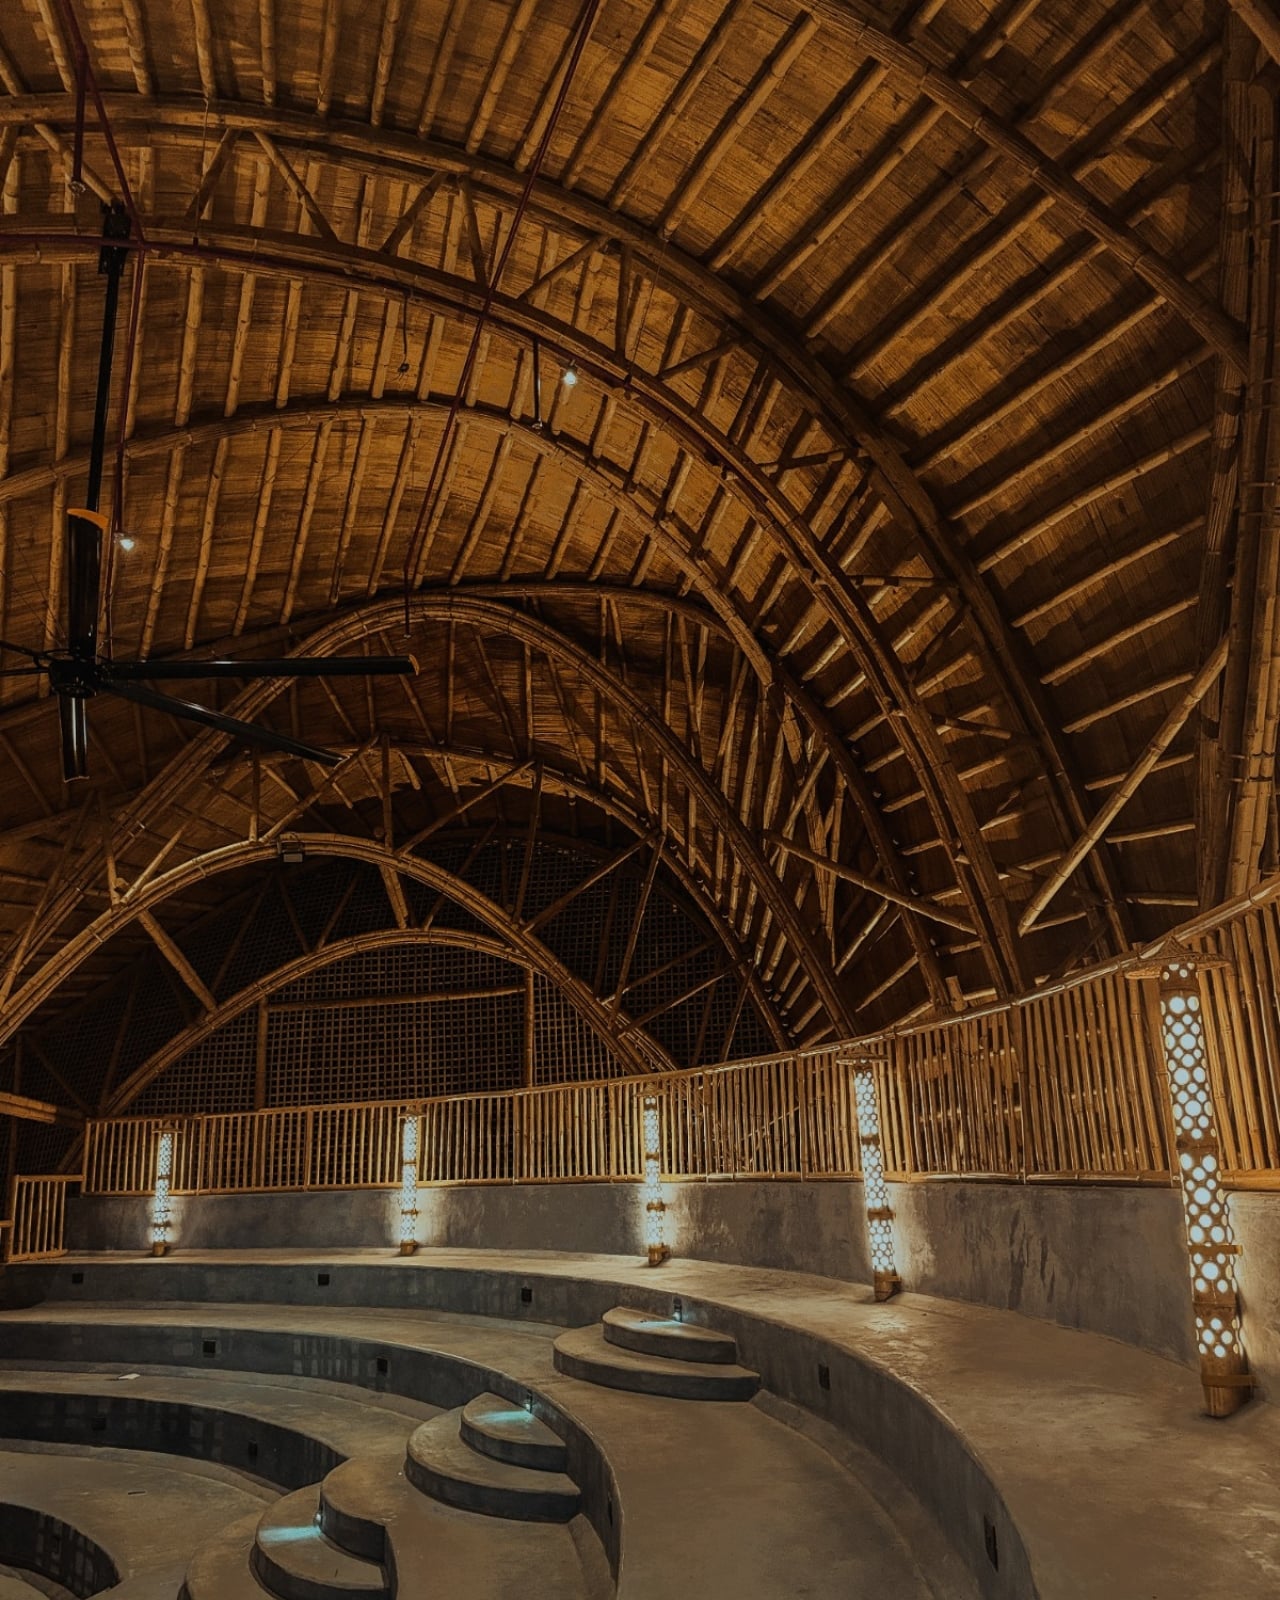
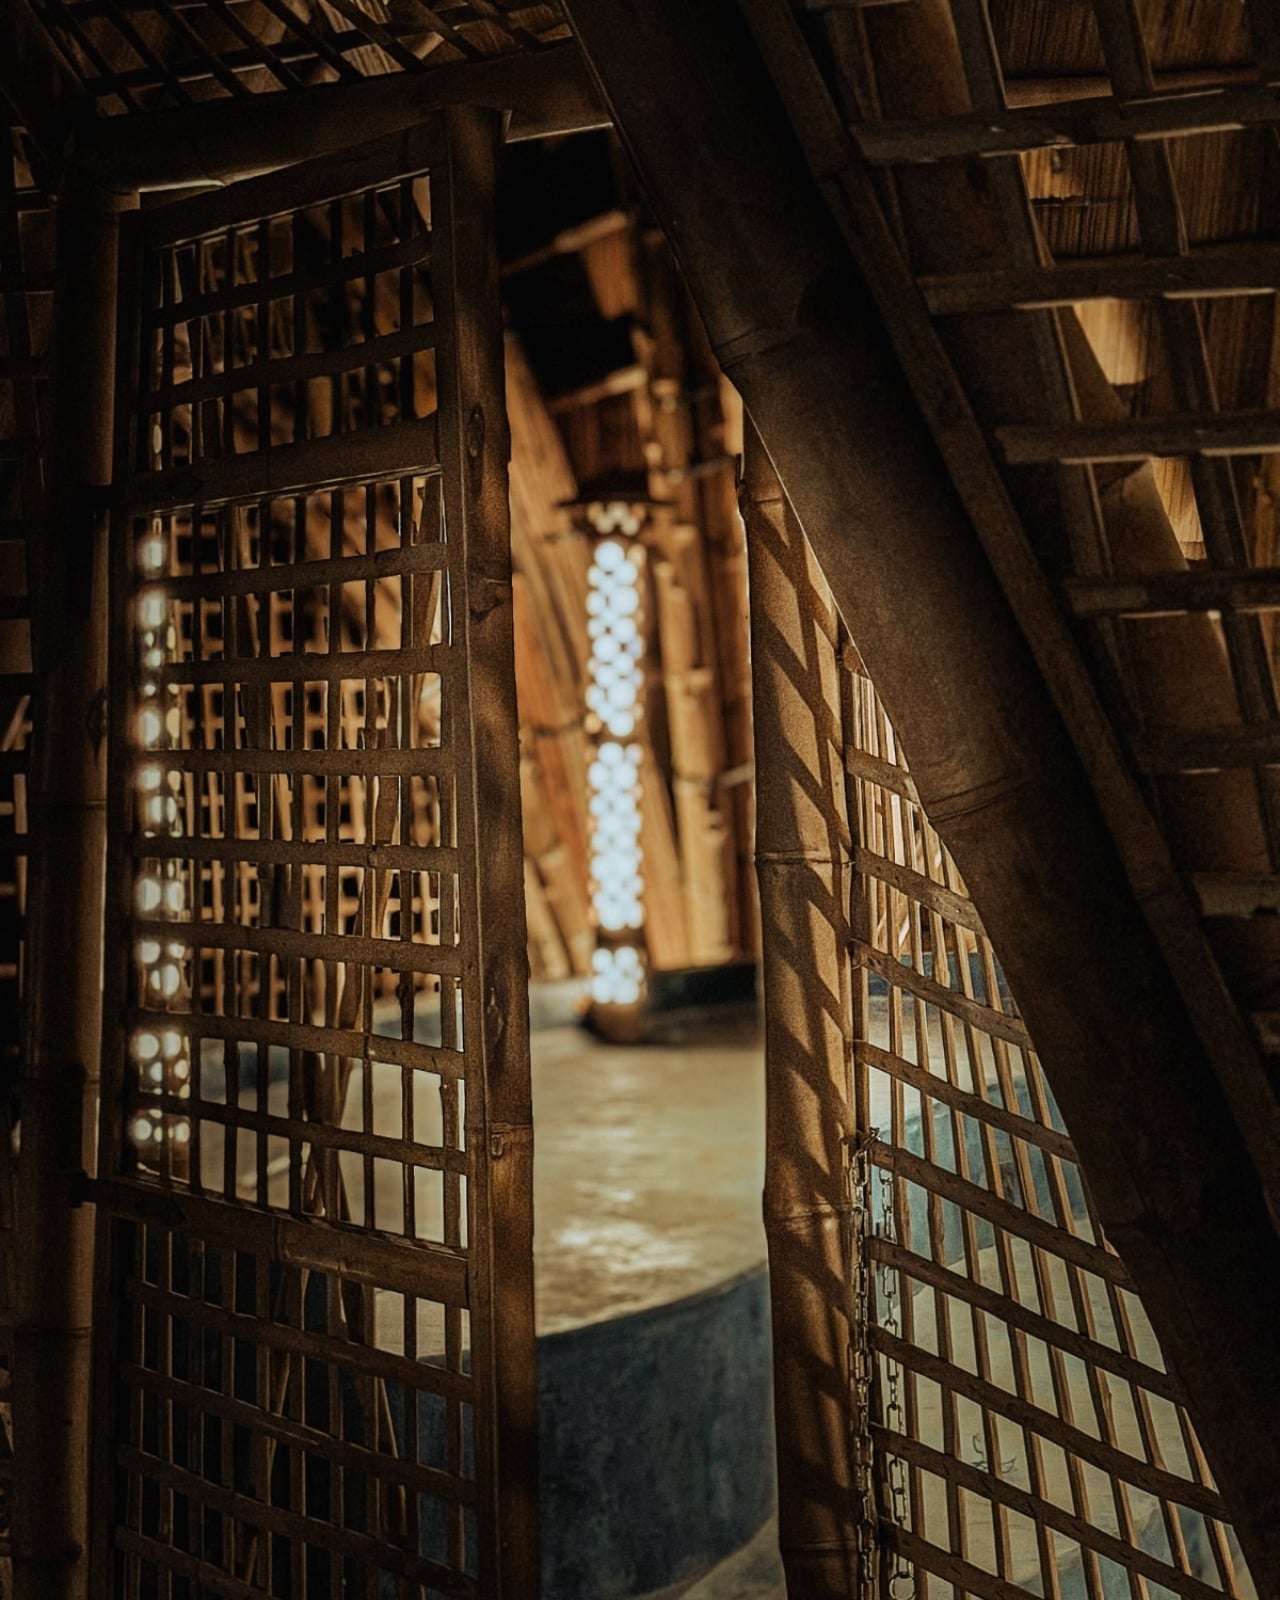
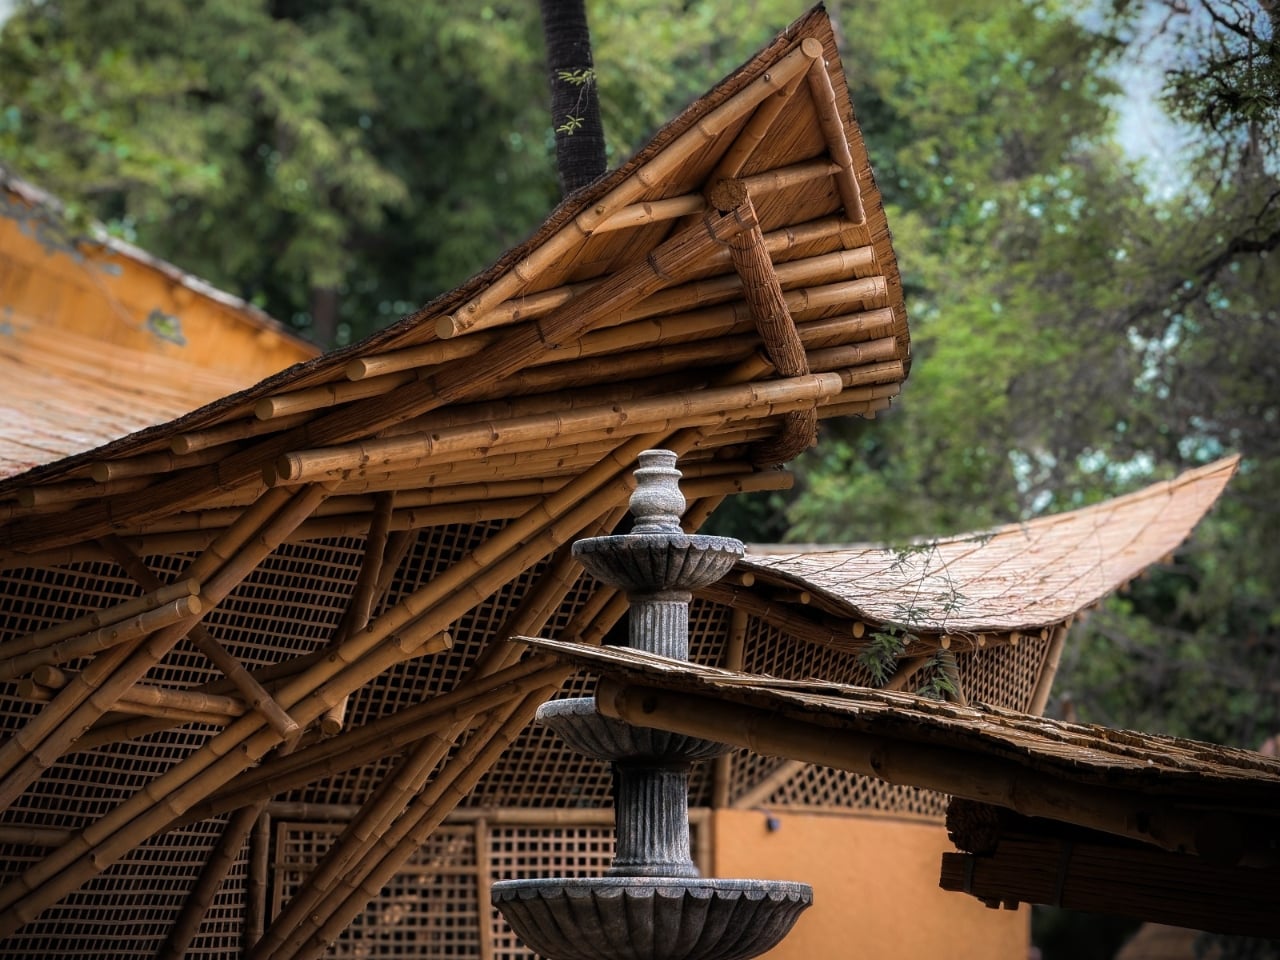
Leaving that construction exposed gives the interiors their character. Ekarth’s material palette includes treated bamboo, lime-based finishes, earthen surfaces, natural-fiber roofing, and handcrafted bamboo weaving. The studio also leaves the bamboo’s connections visible. I’m drawn to buildings that let you follow how they were assembled. Here, the repetition of individual pieces gives the large roof forms a finer scale, so the architecture offers more to examine than its outline from a distance.

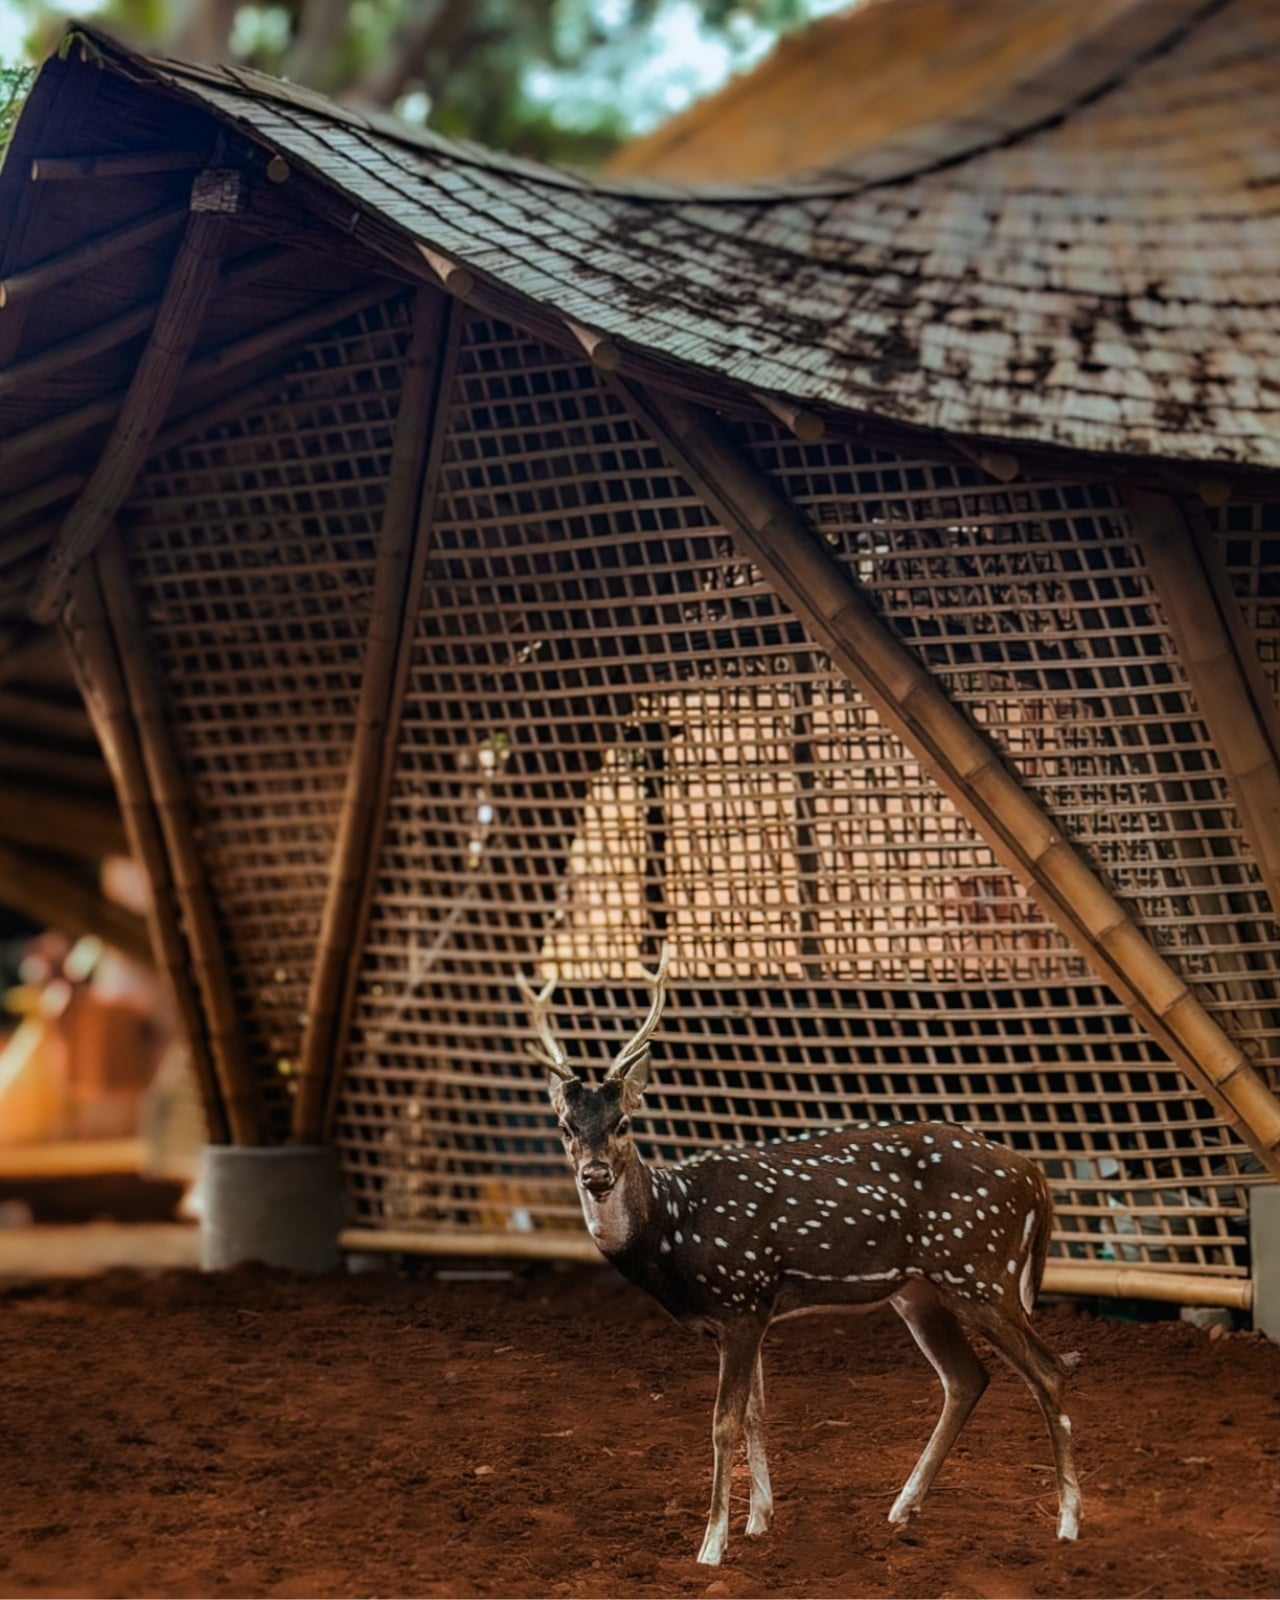
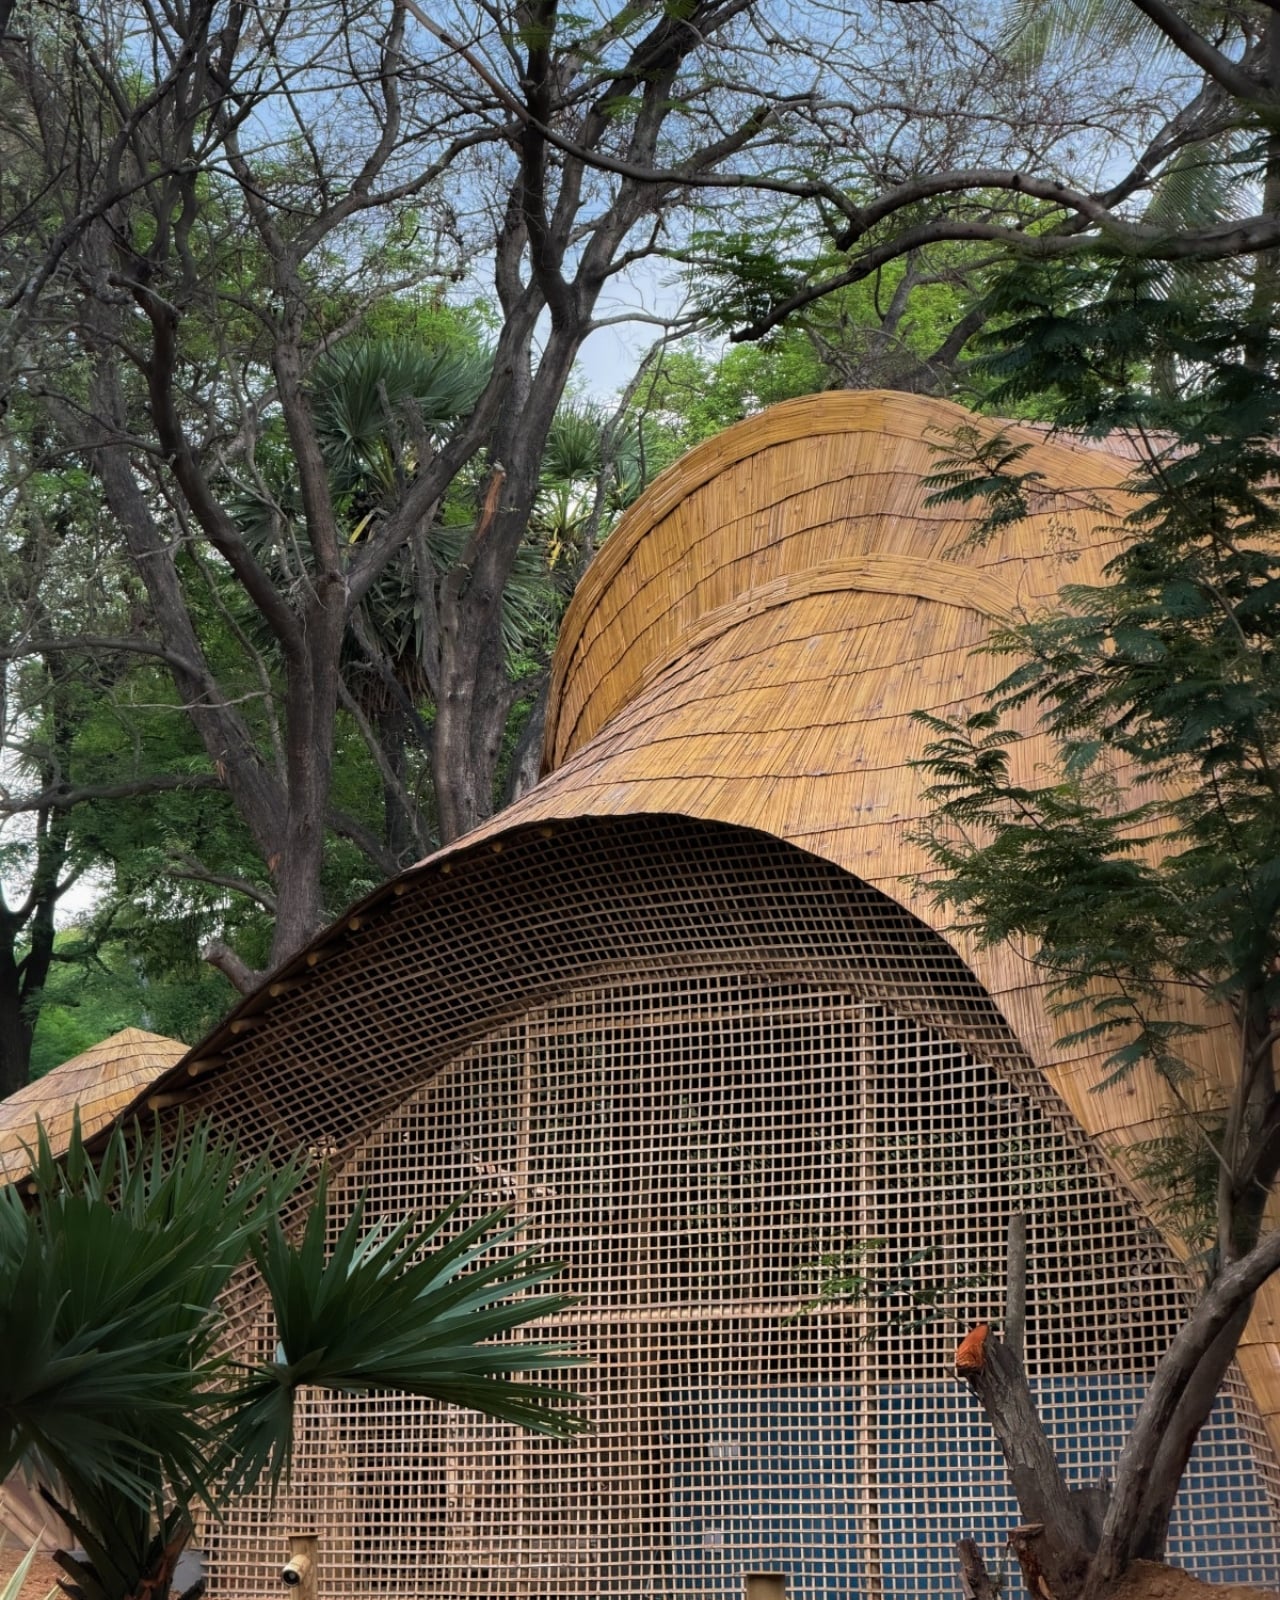
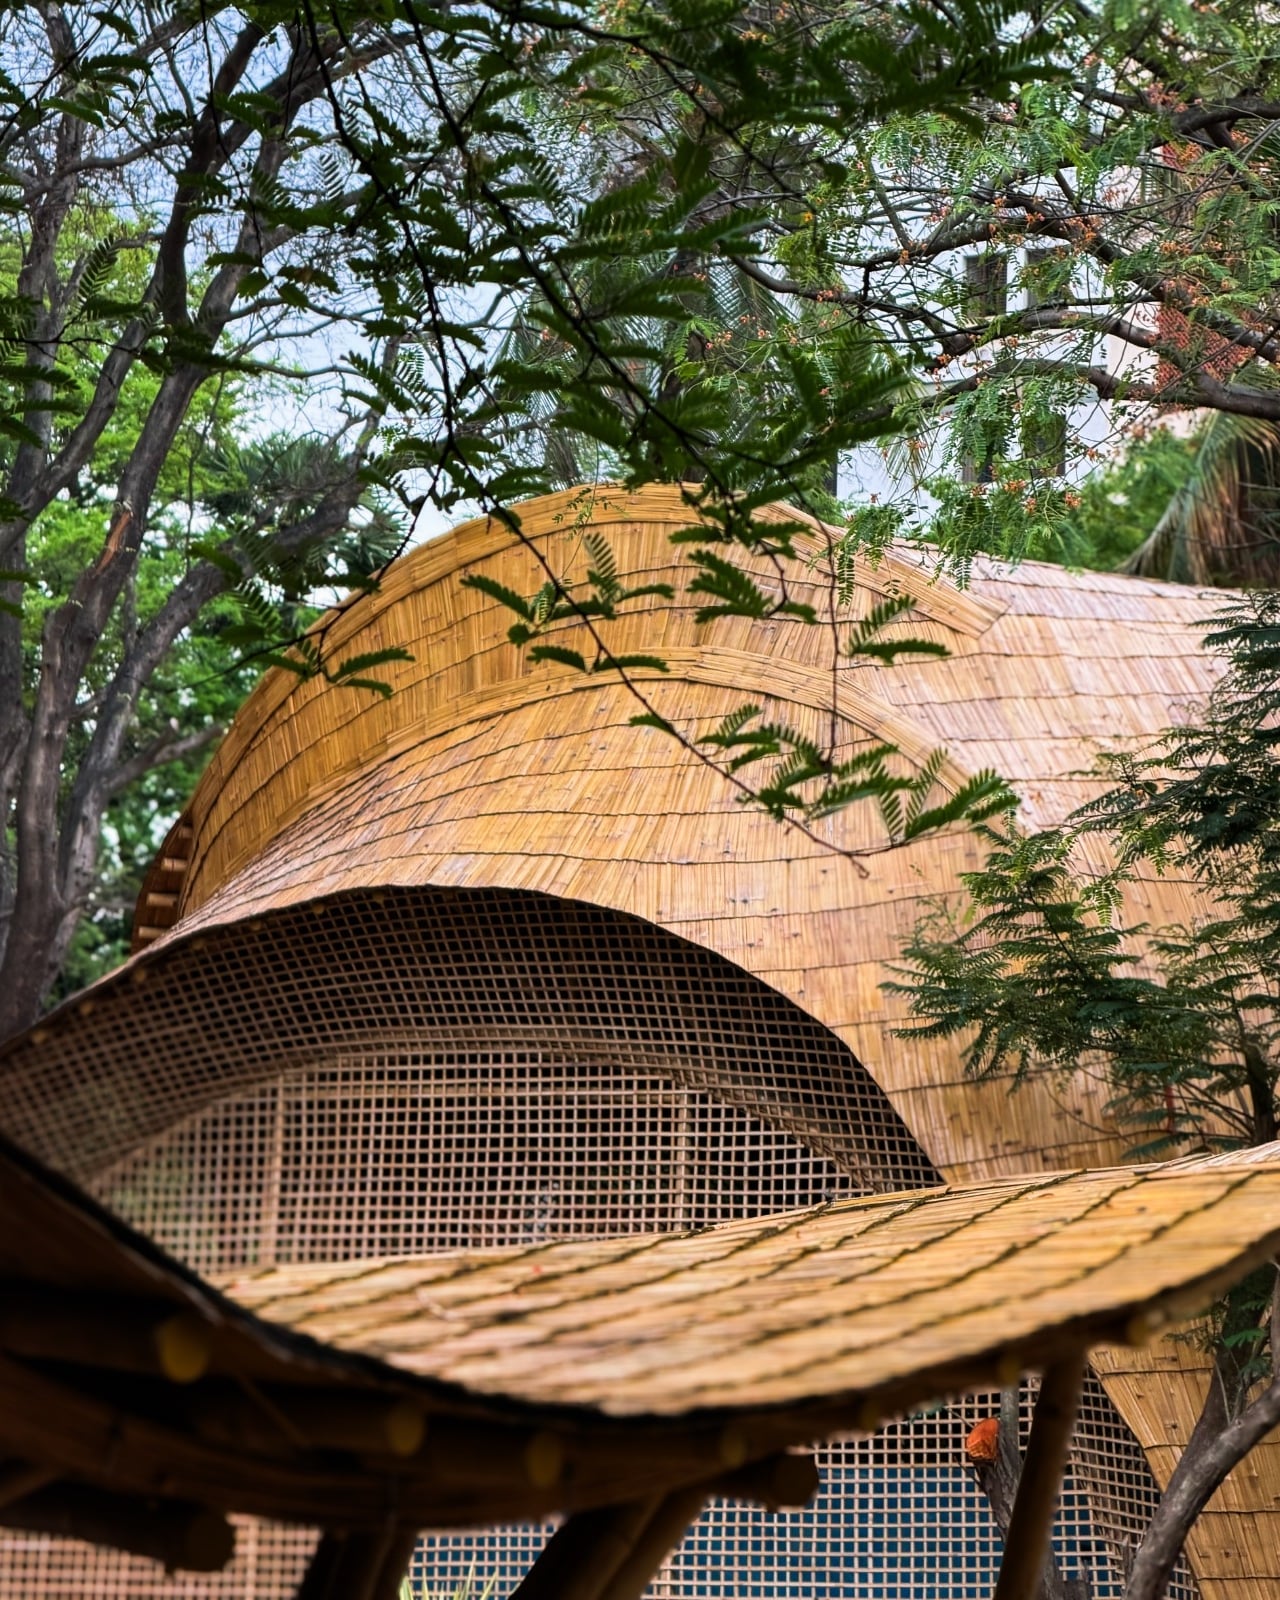
The exterior photographs show roof edges sweeping outward above bamboo lattice screens, with trees close to the pavilions. The small, regular openings in those screens contrast with the broad curves overhead. They make the enclosure look less abrupt than a blank wall would. Ekarth’s plan connects classrooms and other spaces with courtyards and shaded outdoor areas, giving the center an architectural relationship with its surroundings that goes beyond putting landscaping around a finished building.

The people who assembled it deserve attention, too. According to the studio’s account, artisans split, bent, bundled, and joined the bamboo primarily with basic carpentry tools, while structural engineering adapted those processes for an institutional building. Ekarth reports an 11-month construction period with limited use of heavy machinery. That timeline is noteworthy, but I’d give equal billing to the craft. Its contribution remains legible in the finished architecture rather than disappearing behind another surface.

A beautiful bamboo structure doesn’t, by itself, establish how well a recording room isolates sound or how comfortable the building stays throughout the year. Those are separate performance questions, and the published project descriptions don’t provide measurements that settle them. The same restraint applies to sustainability. Natural materials and a less machinery-intensive construction process are choices worth discussing, but they aren’t enough to calculate the building’s environmental footprint or long-term maintenance demands.

Even with those questions open, the design gives me a clear reason to pay attention. The central amphitheater-like gathering space puts rehearsal, performance, and collective learning beneath the same expressive structure. That feels like an appropriate investment for a music center: a memorable room whose defining gesture also keeps its floor open. The ceiling earns its visual complexity by leaving more usable space underneath, where the people and the music belong.

The post A Bamboo Music Center Spans Up to 49 Feet Without Columns first appeared on Yanko Design.

  •  

DOOM - Le moteur de 1993 bouffé par DLSS 5

Dans la série des trucs qui ne servent à rien, mais qui sont bien cools quand même, je vous présente ce bon vieux DOOM de 1993 qui vient de passer au DLSS 5. L'auteur de cette nouvelle prouesse, c'est Nikolai Zhivotenko qui a publié DOOM + DLSS 5 , un port Windows 64 bits de Linux DOOM 1.10 qui conserve le moteur d'origine. Le jeu produit ainsi toujours son image en 320x200 pixels, puis celle-ci est reconstruite dans une fenêtre de 1280x800 en Direct3D 12 par l'upscaler de votre choix.

Ce clic autorise une connexion à Google : adresse IP transmise et traceurs possibles. En savoir plus Voir cette vidéo sur YouTube

Un upscaler moderne ayant besoin d'autre chose que des pixels pour travailler, le moteur modifié doit inscrire à chaque image la profondeur, les normales et le mouvement, et les touches F2 à F4 affichent ces trois vues à la place du jeu.

L'auteur en a même fait un petit banc d'essai, avec un exécutable par mode : DLSS Ray Reconstruction, DLSS Super Resolution en preset K (DLSS 4) ou L (DLSS 4.5), FSR 2.2 d'AMD, Anime4K, et le bon vieux nearest 4x pour comparer. Ray Reconstruction se contente d'ailleurs de buffers factices (spéculaire noir, rugosité à 1), puisque DOOM n'a aucun éclairage path-tracé à lui donner.

Un couloir de DOOM avec l'étiquette "DLSS 5 On" en bas à gauche et trois vignettes de données en haut de l'image (capture fournie par l'auteur du port)

Et le DLSS 5 dans tout ça ?

Eh bien le mode 5 commence par la même passe que le 4.5, avec le SDK officiel de NVIDIA et ensuite seulement, si l'addon RenoDX du DLSS 5 est placé à côté de l'exécutable, une seconde passe laisse le Neural Rendering retoucher l'image. Et ce Neural Rendering là ne vient pas du port mais de DLSS5-Swapper , un outil communautaire sous licence MIT qui injecte le modèle de NVIDIA dans les jeux. Bref, c'est indispensable comme addon pour passer d'un rendu 4.5 à un rendu 5.

Côté NVIDIA, le DLSS 5 dont je vous parlais en mars n'est sorti que le 3 septembre, avec NBA 2K27, sur les RTX 50 et GeForce NOW mais il avait fuité juste avant via des fichiers trouvés dans une mise à jour de ce même jeu. Du coup, les moddeurs l'ont collé dans The Witcher 3 ou Cyberpunk 2077 sans attendre.

Quant au résultat sur DOOM, n'espérez pas avoir du photoréalisme... niet, le modèle n'a pas été pensé pour des sprites en 320x200, et d'après Wccftech, certains détails reconstruits peuvent même ressortir plutôt bizarrement...

Une créature face au joueur, avec la même étiquette "DLSS 5 On" et mêmes vignettes en haut (capture fournie par l'auteur du port)

Maintenant pour tester, il vous faudra un Windows 64 bits, une GeForce RTX, et compiler tout ça vous-même avec le script build.cmd du dépôt. Vous déposez un IWAD dans le dossier wads (celui de Freedoom fait l'affaire), puis vous déclarez le dossier du mode 5 dans Swapper , en route Native. Côté carte, Swapper annonce les RTX 20 à 50 pour ses routes à base de ReShade, dont fait partie l'addon RenoDX , mais prévient quand même que la compatibilité n'est pas garantie.

Et si vous voulez juste comparer, le script screencast-windoom.cmd rejouera la même démo dans chacun des modes et peut même exporter chaque image en PNG.

Amusez-vous bien !

  •  

Mistral Large 4, le modèle à 1 000 milliards de paramètres surnommé Le Chonk

Mistral a présenté Mistral Large 4, un modèle d'intelligence artificielle à 1 000 milliards de paramètres que l'équipe surnomme elle-même "Le Chonk", et l'entreprise française annonce ni plus ni moins que c'est le meilleur modèle ouvert jamais développé en dehors de la Chine. Rien que ça.

Le modèle n'est pour le moment accessible qu'en préversion via l'API de Mistral, l'interface qui permet aux développeurs de la brancher sur leurs applications. Les poids, autrement dit le fichier complet qui permet de faire tourner le modèle sur ses propres serveurs, arriveront le 27 octobre sur Hugging Face, le grand entrepôt public des modèles d'IA.

C'est tout le contraire des boîtes noires d'OpenAI ou d'Anthropic, le créateur de Claude, qui gardent jalousement les leurs.

Sur le papier, le chiffre de 1 000 milliards en jette, sauf que le Chonk n'active que 49 milliards de paramètres à chaque réponse, avec une architecture qui fonctionne un peu comme une grosse administration où seul le guichet compétent traite votre dossier. Du coup, il coûte bien moins cher à faire tourner que sa taille ne le laisse penser.

L'entraînement a pris deux mois sur près de 4 000 puces Nvidia Grace Blackwell installées dans les datacenters européens de Mistral, soit deux à trois fois moins de matériel que la concurrence chinoise d'après Pierre Stock, le responsable scientifique de la maison. Le modèle parle au passage plus de 160 langues.

Mistral insiste surtout sur les capacités agentiques de son Chonk, c'est-à-dire sa faculté à enchaîner tout seul des actions, lancer du code, éplucher des documents, remplir un tableur, plutôt que de simplement répondre à vos questions.

Sur les tests de performance publiés par Mistral, le Chonk se place au niveau des meilleurs modèles chinois de DeepSeek, Alibaba ou Moonshot sur le code, la finance et le droit, avec une vraie pointe en cybersécurité où il se classe parmi les cinq meilleurs au monde. Les mesures indépendantes sont un peu moins flatteuses, puisque le cabinet Artificial Analysis le situe entre DeepSeek et les modèles les plus accessibles d'OpenAI, encore loin du haut de gamme GPT-6 Astra, ce qui est déjà pas mal pour un modèle qu'on pourra télécharger gratuitement.

Côté tarifs, l'API facture environ 0,70 dollar le million de tokens, les morceaux de mots qui servent d'unité de facturation à tous les fournisseurs d'IA. Airbus et HSBC figurent déjà parmi la centaine de clients revendiqués.

J'avoue que je me demande déjà quelle machine il faudra pour faire tourner un bestiau pareil dans un salon, mais c'est tentant.

Source : TechCrunch

  •  

Quick Tunnels - Votre projet localhost sur le web avec invitation

Cloudflare a sorti il y a petit moment maintenant une commande que pas mal de dev utilisent et dont je vais vous parler aujourd'hui : cloudflared tunnel --url, qui permet de publier un serveur tournant sur votre machine à une adresse en trycloudflare.com, sans avoir besoin de compte, de nom de domaine et surtout sans avoir à ouvrir le moindre port sur votre box toute pourrie.

Et la petite nouveauté depuis quelques jours, c'est que, autant avant, n'importe qui possédant le lien pouvait se connecter à votre service, mais maintenant, Cloudflare a mis en place une option qui permet de réserver ce lien à quelques adresses e-mail que vous définissez.

Ce service s'appelle les Quick Tunnels, et pour en profiter, il vous faudra juste un service web qui tourne en local (moi je vais faire ça sur le port 8080 comme d'hab) avec une page de test toute bête servie par Python. Voilà c'est juste de quoi vérifier que tout passe bien avant d'y brancher un vrai projet. Et si vous faites bosser des agents IA avec ce truc, on verra aussi comment mettre un garde-fou pour éviter l'exposition sur le web de trucs pas prévus ! Argh !!

Installer cloudflared

cloudflared, c'est le petit connecteur open source de Cloudflare, celui qui établit la connexion sortante vers leur réseau. Sur Mac, pour l'installer c'est fastoche, suffit d'utiliser Homebrew :

brew install cloudflared

Sous Debian ou Ubuntu, passez par conte par le dépôt officiel de Cloudflare. Il a changé de clé de signature récemment, donc reprenez bien ces commandes plutôt que celles d'autres vieux tutos qui traînent :

sudo mkdir -p --mode=0755 /usr/share/keyrings
curl -fsSL https://pkg.cloudflare.com/cloudflare-main.gpg | sudo tee /usr/share/keyrings/cloudflare-main.gpg >/dev/null
echo 'deb [signed-by=/usr/share/keyrings/cloudflare-main.gpg] https://pkg.cloudflare.com/cloudflared any main' | sudo tee /etc/apt/sources.list.d/cloudflared.list
sudo apt-get update && sudo apt-get install cloudflared

Et sous Windows (les courageux !! lol), la page de téléchargement de Cloudflare propose un MSI ou un exécutable, en 32 ou 64 bits, et le paquet existe aussi chez winget sous l'identifiant Cloudflare.cloudflared. Dans tous les cas, vérifiez ensuite la version, car l'option d'authentification dont on va parler plus bas n'arrive qu'à partir de la version 2026.9.3 :

cloudflared --version

Ouvrir un tunnel public

Tout d'abord, lancez votre serveur local, puis dans un autre terminal, faites :

cloudflared tunnel --url http://localhost:8080

Au bout de quelques secondes, cloudflared affichera un encadré avec une adresse aléatoire composée de quatre mots, du genre quelque-chose-truc-bidule.trycloudflare.com, en prévenant qu'elle peut mettre un moment à répondre. Donc soyez un peu patient, le temps que le DNS résolve ce truc (et videz votre cache DNS si ça veut vraiment pas le faire).

Ensuite, ouvrez cette URL depuis un autre appareil, genre votre téléphone en 4G par exemple et hop, vous tomberaz sur votre serveur local. Et si vous voulez tout couper, un petit Ctrl+C dans le terminal et c'est fini ! Pas de panique, au prochain lancement de cloudflared, vous aurez une nouvelle adresse.

La commande de base, et le cadre où cloudflared affiche l'adresse trycloudflare.com à partager

Notez aussi que le port n'est pas imposé puisque --url accepte tout ce que cloudflared peut joindre, une adresse IP de votre réseau local comprise. Par contre, si votre projet tourne sous Vite, vous allez prendre un "Blocked request" en pleine tronche, car Vite ne répond par défaut qu'à localhost, aux domaines en .localhost et aux adresses IP. La parade la plus simple consiste donc à faire croire à Vite qu'on l'appelle via localhost:5173 en faisant comme ceci :

cloudflared tunnel --url http://localhost:5173 --http-host-header localhost:5173

L'autre solution, c'est d'ajouter l'hôte dans le réglage server.allowedHosts de Vite. Mais évitez de passer ce réglage à true pour aller plus vite, en effet la doc de Vite le déconseille puisque ça expose votre serveur de dev à des attaques par DNS rebinding. Oupsi oups !

Gardez aussi en tête que c'est un outil de test et de démo et que c'est pas fait pour de la prod. Si on en croit la doc , Cloudflare ne garantit aucune disponibilité, sans oublier que chaque tunnel encaisse au max 200 requêtes en simultanné (au-delà, ça vous fera une erreur 429 ) et les Server-Sent Events ne passeront pas. Voilà, donc si vous voulez un nom fixe et du vrai trafic, il faudra plutôt créer un tunnel nommé à partir d'un vrai compte Cloudflare et d'un domaine de votre choix.

Réserver l'adresse à quelques personnes

Et maintenant, pour limiter l'accès à votre service à quelques personnes, ajoutez --allowed-mail suivi de l'adresse email de celui à qui vous voulez montrer votre merveilleux boulot :

cloudflared tunnel --url http://localhost:8080 --allowed-mail [email protected]

L'encardré change alors de "ton" en vous annonçant que le tunnel est "protégé" par une authentification de type code à usage unique via Cloudflare Access, ainsi que la quantité d'adresses autorisées. Les adresses elles-mêmes n'apparaissent nulle part, même dans la ligne des réglages où elles sont remplacées par des astérisques, ce qui est plutôt bien vu si vous faites une démo en mode partage d'écran. Ça évite les fuites de données perso !

Avec --allowed-mail, le cadre annonce le code à usage unique et le nombre d'adresses autorisées, sans jamais les afficher

Vous pouvez ensuite répéter l'option autant de fois que nécessaire, séparer plusieurs adresses par des virgules, ou autoriser tout un domaine. Mettez simplement des guillemets autour du "joker" (c'est l'étoile) pour que votre misérable shell ne tente pas de l'interpréter comme un gros teubé :

cloudflared tunnel --url http://localhost:8080 \
 --allowed-mail [email protected] \
 --allowed-mail [email protected] \
 --allowed-mail '*@example.com'

Côté Wrangler, si vous bossez sur Workers, un petit npx wrangler tunnel quick-start acceptera la même option :

npx wrangler tunnel quick-start http://localhost:8080 --allowed-mail [email protected]

De son côté, votre invité VIP n'aura alors plus qu'à ouvrir l'URL que vous lui avez donné et cloudflared renverra son browser vers login.trycloudflare.com. Il tombera alors sur une page Cloudflare Access qui lui demandera son adresse mail. Il recevra ensuite un code dans sa boîte, devra le taper, et arrivera enfin (ouf !!) sur votre merveille application probablement vibe codée (lol).

Et quelqu'un qui n'est pas sur la liste des invité ne verra quand à lui qu'une réponse de base lui expliquant qu'il peut bien aller se faire voir (et sa requête n'atteindra jamais votre application).

Ce que voit votre invité en ouvrant l'URL protégée : la page Cloudflare Access qui lui demande son adresse mail

Et votre liste d'emails, elle, n'est jamais diffusée hors de votre ordi puisque Cloudflare vérifie seulement que la personne contrôle l'adresse qu'elle a saisie. Ensuite c'est cloudflared qui compare les accès en mémoire, avec ce que vous avez tapé. Une fois entré, le visiteur gardera alors sa session jusqu'à 4 heures max.

Et si vous voulez modifier cette liste d'accès, il faudra alors arrêter le tunnel et en relancer un autre, ce qui coupera l'accès à tout le monde et vous donnera une nouvelle adresse à renvoyer. Donc soyez sûr de votre coup avant de casser la tête aux gens qui vont tester votre appli.

Sachez aussi que cette vérification ne pourra se faire qu'avec un vrai navigateur et pas des trucs du genre un webhook Stripe, un GitHub, un script en curl ou encore n'importe quel client automatique qui restera coincé devant cette page de connexion.

Pour ces cas-là précieusement, je vous recommande plustôt d'ouvrir un tunnel public le temps du test et de le couper juste après. Et si le webhook doit tourner durablement, passez sur un tunnel nommé avec Cloudflare Access, sur votre propre domaine.

Le confier à votre agent IA

Maintenant, parlons un petit peu à agents IA parce que oui... Un agent de code a besoin d'un endroit pour vous montrer ce qu'il vient de faire de beau, et Cloudflare décrit justement ce cas de figure dans son article.

Pour éviter qu'un agent IA ne diffuse publiquement ce qu'il vient de faire à la vue de tous, ce que recommande Cloudflare, c'est donc d'ajouter une ligne dans le fichier d'instructions de l'agent AGENTS.md comme ceci :

Quand tu lances un Quick Tunnel, ajoute toujours --allowed-mail [email protected].

Sauf qu'une consigne reste une consigne... C'est un prompt que l'agent peut choisir d'ignorer... Donc gardez bien en tête que ces fichiers sont traités comme du contexte et pas comme une configuration imposée.

Maintenant, si vous voulez vraiment bloquer une action, peu importe ce que décide le modèle, ce que je vous recommande d'utiliser à la place, c'est un hook "PreToolUse". Moi, j'en mets partout dans mes configs Claude Code pour plus de sécurité.

Si vous ne savez pas ce qu'est un hook, en fait c'est un petit script contenant la commande en JSON, et que Claude Code lance avant chaque commande bash. Si ce script se termine avec le code "2" l'appel est alors bloqué. Pour faire ça, il faut donc créer dans le dossier .claude/hooks/ de votre projet, le script suivant :

#!/bin/bash
# .claude/hooks/tunnel-protege.sh
COMMAND=$(jq -r '.tool_input.command')

if echo "$COMMAND" | grep -qE 'cloudflared.*tunnel.*--url|wrangler.*tunnel.*quick-start' \
 && ! echo "$COMMAND" | grep -q -- '--allowed-mail'; then
 echo "Quick Tunnel public refusé : ajoutez --allowed-mail, ou demandez-moi d'abord." >&2
 exit 2
fi
exit 0

Puis rendez-le exécutable avec chmod +x, et installez jq si vous ne l'avez pas encore fait.

Déclarez-le ensuite dans le .claude/settings.json du projet, sur l'outil Bash comme ceci :

{
 "hooks": {
 "PreToolUse": [
 {
 "matcher": "Bash",
 "hooks": [
 {
 "type": "command",
 "command": "${CLAUDE_PROJECT_DIR}/.claude/hooks/tunnel-protege.sh"
 }
 ]
 }
 ]
 }
}

Maintenant, si ça vous prend trop le chaud de faire ça, sachez que j'ai fait un petit kit à télécharger ici, pour les Patreons :

Ensuite, à partir de là, un cloudflared tunnel --url ou un wrangler tunnel quick-start lancé sans le paramètre --allowed-mail ne fonctionnera pas, et l'agent recevra le message du hook qui lui dira d'ajouter l'option ou de vous demander s'il doit y avoir un contournement.

Et bien sûr, un tunnel nommé lancé avec cloudflared tunnel run, lui, passera normalement.

Comme d'hab, ce genre de garde-fou a ses limites, puisqu'il ne lit que le texte de la commande et ne vérifiera pas l'adresse qui suit l'option. Il ne verra non plus les tunnels qui pourraient être lancés depuis un script ou à l'aide d'une variable d'environnement TUNNEL_URL, qui permet aussi de lancer un Quick Tunnel. Voilà, donc laissez la consigne dans AGENTS.md en plus du hook, au cas où... Les deux devraient bien se compléter.

Pour les soutiens Patreon , le kit ci-dessus reprend donc ce hook avec les consignes à coller dans AGENTS.md, dont l'exception des clients automatiques (l'agent vous demande au lieu de retirer l'option).

Il y a aussi là dedans un script qui lance le tunnel protégé et ne renvoie que son adresse. Et si vous préférez scripter ça vous-même, partez de --output json, qui transformera chaque ligne du log en objet JSON. L'adresse sera alors accessible dans le champ message, et vous pourrez alors l'extraire avec une expression régulière.

Ah et un dernier point avant de lâcher un agent là-dessus sur le portable de votre boulot, je vous invite à lire ce que Proofpoint a documenté concernant des campagnes de malware qui s'appuient sur ce genre de tunnels gratuits. Ça explique pourquoi des outils de sécurité comme Elastic ont des règles qui repèrent cloudflared quand il est utilisé pour exposer un service local. Leur conseil c'est de bloquer les domaines de tunnel quand l'usage n'est pas autorisé, donc si vous comptez utiliser ça dans votre boite, allez voir Dieu Tout Puissant (le sysadmin grognon quoi...) pour lui demander l'autorisation. Il va pester, souffler, éventuellement vous cracher dessus puis finira probablement par accepter, donc pas d'inquiétude ^^.

Et comme la protection par mail est gratuite, au même titre que les Quick Tunnels eux-mêmes, je ne vois aucune raison valable de balancer une démo accessible sur le web sans utiliser cette authentification.

  •  

SlopTotal - Un détecteur de texte IA à installer chez vous

SlopTotal est un projet qui se présente lui-même comme le "VirusTotal du texte IA", alors faut pas s'étonner que ça m'intéresse ! Vous y collez un texte, un PDF ou une URL, et ensuite 23 détecteurs le passent au crible, en parallèle à l'aide de classifieurs neuronaux, de tests statistiques et autres heuristiques. Ensuite, un score calibré de 0 à 100 résume leurs avis et doit vous dire normalement si tel ou tel texte a été écrit avec de l'IA

J'ai donc installé ça sur ma machine puis passé 36 textes divers et variés (IA et humains) dans mon instance. Parmi eux, 24 ont été écrits par Claude, ChatGPT et Gemini (12 en français, 12 en anglais), avec comme consigne d'avoir un ton neutre, et pour d'autres un ton de "blogueur" ^^. Les 12 autres textes, eux, sont humains. Je lui ai donné 6 de mes articles écrits entre 2018 et 2021 ainsi que 6 billets de blog tech en anglais publiés entre 2020 et 2021.

Voici donc mes résultats...

Sur les 12 textes humains, 4 ont été pris pour de l'IA (verdict "Likely AI-generated" ou pire), ce qui représente 33 %, et ils étaient tous en anglais !! Et sur mes 24 textes écrits par une IA, 9 ont été pris pour une réalisation humaine (verdict "Clean"), ce qui équivaut à 38 %. Ah et ils étaient tous en français.

Le README annonce pourtant mieux comme résultats donc je suis assez étonné (1 texte humain sur 66 classé "Likely AI"), mais sur d'autres genres de textes, comme la presse ou les livres et en 100% english. Alors oui, mon échantillon est petit, mais pour savoir si un texte vient d'une IA, SlopTotal ne me semble pas fiable

Le rapport de SlopTotal pour un article de 455 mots écrit par Claude : 23,6 sur 100, verdict "Clean", 4 moteurs sur 23 en alerte.

Le rapport de SlopTotal pour un billet du blog d'avril 2020 : 56,9 sur 100, "Likely AI-generated", 9 moteurs sur 23 en alerte.

Après c'est pas un nouveau problème car je pense par exemple à OpenAI qui a retiré son propre classifier en juillet 2023 parce que la précision était trop faible ( The Register ). Vanderbilt a débranché également celui de Turnitin le mois suivant et des chercheurs de Stanford ont testé en 2023, 7 détecteurs en leur faisant analyser 91 rédactions humaines TOEFL de non-anglophones et en moyenne, ils en ont pris 61 % pour de l'IA.

Toutefois, 2 études plus récentes ont également testé des détecteurs commerciaux (pas SlopTotal donc...), et sur du texte humain ancien, elles se rejoignent. Le NBER trouve par exemple un taux de faux positifs quasi nul chez Pangram, de 0,1 à 0,3 % chez OriginalityAI et d'environ 0,7 % chez GPTZero, sur 1 992 textes humains d'avant 2020. De son côté, le chercheur Jonathan Karr et ses collègues n'ont trouvé aucun positif IA en testant avec Pangram et GPTZero, des tonnes de résumés textes datés de 2013 à 2015.

Par contre, ces études divergent sur l'humanisation. Par exemple, selon le NBER, Pangram tient bon face à l'humanizer StealthGPT alors que moins de 4 % des textes IA passés par Undetectable AI restent signalés chez Karr. Ce dernier note aussi qu'à l'inverse, un résumé écrit par un humain et simplement retouché par une IA est quant à lui, signalé comme IA dans 38 à 80 % des cas. Ça pourrait expliquer pas mal de petits problèmes de "littérature" qu'on a en ce moment, looool.

Bref, installez-le pour vous faire votre propre idée, en commençant par des textes dont vous connaissez l'auteur, mais surtout pas pour "accuser" quelqu'un. Je pense d'ailleurs qu'aucun détecteur ne devrait être la seule preuve d'une accusation... Par exemple, un texte humain qui est passé dans un correcteur orthographique full IA ou alors un texte qui est dicté avec un modèle de speech to text IA peuvent très bien être reconnus comme étant des textes IA alors qu'en fait ce sont juste des textes écrits / dictés par des humains et qui ont été "un peu" modifiés ou "un peu" réorganisés par un LLM. Je dis ça parce que c'est exactement ce que fait mon application de reconnaissance vocale Kassis , qui dispose de fonctionnalités de correction et de réécriture... héhé.

Source : SlopTotal sur GitHub

  •  

DLSS 5 sur Radeon, ça fonctionne

DLSS-NR on AMD est un mod pour Windows capable de faire tourner sur une Radeon le fameux Neural Rendering du DLSS 5, la technologie de Nvidia dont tout le monde parle. Ce mod vise les AMD RX 9000 mais les RX 7000 sont censées fonctionner aussi, et il se greffe également sur les jeux DirectX 12 qui gèrent déjà le FSR d'AMD.

Le principe c'est qu'en toute dernière étape du rendu, le DLSS 5 ajoute de l'éclairage et des tas de détails de matière à l'image que le jeu vient de calculer. Nvidia l'a mis en place sur NBA 2K27 en partenariat avec Visual Concepts et 2K, alors que le mod DLSS-NR on AMD l'applique déjà à Cyberpunk 2077, qui n'a pourtant pas été conçu pour ça. Je me rappelle quand même que la démo du DLSS 5 avait été très mal accueillie en mars parce qu'elle donnait l'impression d'écraser la direction artistique des jeux mais on dirait que ça passe un peu mieux aujourd'hui... Soit les gens se sont habitués, soit le logiciel fait du meilleur taf, je ne sais pas.

D'après le README du projet, pour installer ça sur votre ordi, vous devez placer le programme d'install de la dernière release dans le dossier de l'exécutable du jeu (bin\x64 pour Cyberpunk 2077), à côté d'une DLL de Nvidia . Ensuite vous le lancez, puis vous démarrez le jeu et activez le FSR. La touche Fin ouvrira alors l'overlay du mod, et si vous voulez mettre à jour tout ça ou le virer, il suffit de relancer l'installateur.

Il faut aussi Windows 11 et le pilote Adrenalin 26.1.1 ou plus récent et comme les jeux avec anti-triche bloquent la DLL, vaut mieux pas vous lancer en multi avec ce mod.

Par contre, sachez-le, les résultats en termes de FPS ne sont pas toujours au rendez-vous si j'en crois les benchmarks publiés sur les pages du projet.

Maintenant à vous de voir si vous faites confiance à ce mod puisque le code n'est pas publié. Notez que 2 autres projets similaires pourraient également vous intéresser... Il y a lmxxf , sous licence MIT qui se limite aux RX 9000 et embarque les poids de Nvidia extraits d'une copie locale de la DLL. Et aussi AMDNR de 3zwr1 qui est intégré à OptiScaler.

Mais en tout cas, si vous essayez DLSS-NR on AMD sur une RX 7000, sachez que son auteur demande des retours donc n'hésitez pas à lui envoyer votre fichier dlssnr_on_amd.log si vous rencontrez des bugs.

Source : Tom's Hardware

  •  

Conteneurs Linux - Quand l'isolation ne tient plus

La société de sécurité Depthfirst a publié un billet que j'ai trouvé intéressant dans lequel ils expliquent en gros que les conteneurs (Docker et compagnie) ne sont plus une barrière de sécurité suffisamment solide. La thèse du papier, c'est qu'il faut désormais partir du principe qu'un attaquant (hacker ou malware) saura sortir d'un conteneur quand il le veut, sans grande difficulté.

En effet, un conteneur comme ceux que font tourner Docker ou Kubernetes, donne à un programme l'impression d'avoir sa propre machine. Sauf qu'en réalité, il n'embarque pas de système d'exploitation. Tous les conteneurs d'un serveur passent par le même noyau Linux qui est celui de l'hôte et dont le rôle est de gérer pour eux la mémoire, le processeur ainsi que le réseau.

Toutefois, beaucoup d'organisateurs de CTF notamment s'y fient les yeux fermés et hébergent plusieurs épreuves sur le même serveur, chacune dans son conteneur, en comptant uniquement sur la sécurité de l'hôte. Mais c'est un faux sentiment de sécurité, j'en veux pour preuve ce bulletin de sécurité d'AWS daté de novembre 2025 où il est expliqué que l'entreprise ne considère plus les conteneurs comme une barrière de sécurité et ne s'en sert donc plus pour isoler ses clients les uns des autres.

Ce qui a changé depuis quelques mois, vous le savez, c'est le prix d'entrée de la recherche de failles puisqu'avec les modèles d'IA de pointe, même un attaquant avec des moyens modestes peut fabriquer sans effort, dès la publication d'une faille, un exploit contre des machines qui ne sont pas encore corrigées, alors qu'avant ça demandait de sérieuses compétences.

source : Depthfirst

Et les chiffres publiés par Depthfirst montrent que tout ça s'accélère puisque 249 CVE ont été publiées pour le noyau Linux en janvier, et en août on en a eu 1 650 !

Depthfirst relève également que sur les 36 CVE divulguées via le kernelCTF de Google, 13 sont réalisables via des interfaces ordinaires comme celles qu'un conteneur reçoit par défaut (dont les sockets locaux). En fait, on en croise sans le savoir dès qu'on passe systemd, Docker ou une base de données locale.

Le 24 juillet dernier, Depthfirst a même décroché une place au kernelCTF avec un exploit 0day (donc avant tout correctif) et aujourd'hui, le PoC est en accès libre sur GitHub. Rassurez-vous, côté noyau Linux, le correctif est sorti le 6 août mais malheureusement, côté Ubuntu la mise à jour au 24 septembre, affichait encore que le noyau de la 26.04 était en "Vulnerable, work in progress" et celui de la 24.04 en "Vulnerable". Bref, trouver des vulns ça va vite. Fixer ces vulns sur TOUTES les releases et les machines, ça prend du temps. Alors qu'avant c'était l'inverse. Bref, tout a été chamboulé et c'est un peu la merde maintenant niveau cybersécurité pour patcher rapidement.

Alors comment se protéger de tout ça ?

Hé bien la solution de Depthfirst va vous mettre en PLS car eux proposent carrément de ne plus partager le noyau. Ils recommandent à la place de migrer les charges non fiables vers des microVM, autrement dit des machines virtuelles légères où chaque charge aura son propre noyau. Le projet Firecracker en fait partie tout comme Kata Containers comme ça, en théorie, si un attaquant casse l'un de ces noyau, il ne compromet que sa propre instance et pas l'hôte dans son entièreté ni ses voisins.

Reste que Firecracker s'appuie sur KVM, la brique de virtualisation du noyau Linux de l'hôte. Et comme vous le savez, KVM a eu ses propres failles. En effet, cet été, la faille Januscape ouvrait en grand la porte de la machine physique à un attaquant pourtant enfermé dans sa VM, à condition bien sûr que l'hôte autorise la virtualisation imbriquée (une VM dans la VM). Alors certes, la surface d'attaque est plus petite mais loin d'être nulle.

Voilà, en attendant, si vous êtes sous Ubuntu 24.04 ou 26.04, surveillez bien la mise à dispo du prochain noyau. Canonical a d'ailleurs annoncé il y a peu, une publication hebdomadaire des noyaux pour tenter de compenser cet emballement.

Source : le billet de recherche de depthfirst

  •  
❌